Ich habe mir im Frühjahr das eigene Monitoring ausgesperrt. Nicht durch einen Fehler im Monitoring, sondern durch mein eigenes fail2ban. Der Check auf meinem Überwachungshost klopfte alle 30 Sekunden an Port 22 von acht Servern, um zu prüfen, ob SSH überhaupt antwortet. Er hat sich nie authentifiziert, nur die Verbindung geöffnet und wieder geschlossen. sshd hat brav für jeden dieser Klopfer eine Zeile ins Journal geschrieben, das sshd-Jail von fail2ban hat brav mitgezählt, und nach fünf Treffern innerhalb von zehn Minuten war der Überwachungshost weg. Erst von einem der acht Server, dann von allen. Auf meinem Dashboard wurde alles rot, und ich saß zwanzig Minuten davor und habe an Netzwerkkabel, DNS und den Router gedacht, bevor ich auf die Idee kam, selbst nachzusehen, wer da eigentlich gebannt wird.
Das ist fail2ban in einer Anekdote. Es hat exakt das getan, was ich ihm konfiguriert hatte. Es hat Muster gezählt, die nach Angriff aussahen, und war im Recht. Nur wusste es nicht, wer ich bin.
Genau an dieser Stelle setzt CrowdSec an. Nicht mit besseren Regex, sondern mit einer anderen Frage: Wer ist diese IP, und was haben andere mit ihr erlebt? Dieser Artikel ist der Vergleich, den ich mir vor dem Umstieg gewünscht hätte, mit den Zahlen aus unserem eigenen Anbietervergleich 2026 und den Fallstricken, die in keiner Installationsanleitung stehen.
Warum ich fail2ban nach zehn Jahren in Frage gestellt habe
fail2ban ist bei mir seit ungefähr 2014 auf jedem Server. Es ist klein, es ist aus Debian-Paketen in einer Minute installiert, und es hat über die Jahre sehr viel Brute-Force-Verkehr aus meinen Auth-Logs herausgehalten. In meinem Artikel zur SSH-Härtung kommt es deshalb nur als Nebensatz vor, weil es dort schlicht die letzte Verteidigungslinie ist und nicht die interessante Geschichte.
Was mich zum Umdenken gebracht hat, war nicht ein einzelner Vorfall, sondern ein Muster in den Zahlen. Ich habe über Monate mitgezählt, wie viele verschiedene IPs pro Woche gegen meine sshd-Ports laufen, und irgendwann aufgefallen, dass ich dieselben Adressen und dieselben Netze immer wieder sehe. Nicht ein paar Überschneidungen, sondern im Kern dieselbe Handvoll Angreifer-Infrastruktur, die von Woche zu Woche rotiert. Und mein fail2ban hat jede dieser Wiederholungen jedes Mal aufs Neue gelernt. Ein Ban auf einem Server, und der nächste Server im Pool hat dieselbe IP noch völlig unbedarft hereingelassen, weil dort niemand davon wusste.
Das ist der Punkt, an dem ein lokales Werkzeug an seine Grenze kommt. Es erkennt Sünden, aber es lernt nichts über den Sünder.
Zwei Denkweisen: Muster erkennen oder Verhalten erkennen
Der Unterschied zwischen den beiden Werkzeugen ist kein Detail der Implementierung, sondern ein Unterschied im Weltbild. Wer das einmal versteht, muss nicht mehr über Konfigurationsdateien diskutieren.
fail2ban: ein Jail, ein Regex, alles lokal
fail2ban liest Logzeilen. Zu jedem Jail gehört ein Filter, der in einer INI-Datei aus einer Failregex und einer Ignoreregex besteht, dazu Werte wie maxretry, findtime und bantime. Passt eine Zeile auf die Failregex, wird ein Zähler für die Quell-IP erhöht. Ist der Schwellwert erreicht, trägt fail2ban die IP in eine lokale Ban-Liste ein und setzt eine Regel in iptables oder nftables, häufig auch nur über eine eigene Kette.
Diese Konstruktion ist ehrlich, transparent und extrem leicht zu verstehen. Sie hat aber eine Eigenschaft, die man nicht wegkonfigurieren kann: Ein Jail sieht nur, was in den Logs steht, die er selbst liest. Auf Server A weiß niemand, dass Server B dieselbe IP vor drei Minuten gebannt hat. Und ein Filter kann nur erkennen, was nach Zeilenmuster aussieht, also nicht, dass eine IP sich gerade völlig atypisch verhält.
CrowdSec: Szenarien, Parser und getrennte Rollen
CrowdSec liest dieselben Logs, arbeitet aber in drei getrennten Stufen. Parser zerlegen eine Logzeile in benannte Felder, Szenarien beschreiben in YAML, welches Verhalten auffällt, und die Security Engine entscheidet daraus, ob eine IP gebannt, gedrosselt oder mit einem Captcha belegt wird. Der entscheidende Teil ist, dass Szenarien Verhalten beschreiben können und nicht nur einzelne Zeilen: nicht "fünf Zeilen mit Failed password", sondern "dieselbe Quell-IP probiert binnen zwei Minuten zwölf verschiedene Benutzernamen an drei Diensten aus".
Dazu kommt die zweite Quelle von Wissen, die fail2ban prinzipiell nicht haben kann: die Central API. CrowdSec-Installationen, die sich freiwillig an der Community beteiligen, melden ihre Bans und bekommen im Gegenzug Signale zurück, welche Netze anderswo schon aufgefallen sind. Das ist kein Virenscanner für IPs, sondern ein Frühwarnsystem, das vor dem ersten eigenen Angriff greift.
Wenn du bisher nur mit fail2ban gearbeitet hast, lohnt sich für das Grundverständnis der Blick auf meinen Artikel zu journald und strukturierten Logs, weil CrowdSec genau davon lebt: saubere Felder statt Zeilen, die man mit Regex zurechtbiegen muss.
Der Community-Effekt: über 92 % der Angriffe sind Wiederholungstäter
Die interessanteste Zahl aus unserem Anbietervergleich 2026 ist diese: Mehr als 92 % der Angriffe, die auf einen mit CrowdSec geschützten Server einliefen, kamen von IP-Adressen, die der Community zu diesem Zeitpunkt bereits bekannt waren. Nicht 92 % der Logzeilen aus dem eigenen Netz, sondern 92 % der gemessenen Angriffe auf einen geschützten Server waren Adressen, die irgendwo anders schon aufgefallen waren.
Eine solche Zahl verändert die Verteidigungslogik. Wenn neun von zehn Angriffen von bekannten Tätern kommen, wird die spannende Frage nicht mehr "Wie erkenne ich diesen Angriff?", sondern "Wie kurz ist mein Fenster zwischen erster böser Zeile und Ban?" Genau hier zahlt sich die Community-Liste aus: Eine IP, die bereits anderswo gebannt ist, muss bei mir gar nichts mehr anstellen, um gebannt zu werden.
Das heißt ausdrücklich nicht, dass die eigene Erkennung unwichtig wird. Die verbleibenden knapp 8 % sind die eigentlich gefährlichen, weil sie neu sind oder gezielt gebaut wurden. Genau für sie laufen die lokalen Szenarien weiter, und deswegen ist CrowdSec kein Ersatz für Verhaltensanalyse, sondern eine Ergänzung darum. Wer sich den Unterschied in Zahlen ansehen will, kann das mit dem Zeitstempel-Konverter nachvollziehen, sobald er eigene Log-Zeitstempel gegen die Ban-Zeitstempel stellt.
Der Botnetz-Fall: 7.000 Maschinen, 50 Minuten gegen 5
Den deutlichsten Beleg für den Unterschied liefert ein Botnetz-Fall aus dem Vergleich: Ein Botnetz mit rund 7.000 Maschinen ging auf einen geschützten Server los. CrowdSec hatte mehr als 95 % dieser Maschinen in unter fünf Minuten gebannt. Der Grund war nicht eine besonders schlaue Regel, sondern die Kombination aus schnellem Erstsignal und Community-Wissen über die beteiligten Netze.
Mit fail2ban wäre derselbe Angriff technisch beherrschbar, aber deutlich langsamer gewesen. Bei mehreren tausend Logzeilen pro Minute hätte der Filter erst diese Menge an Zeilen verarbeiten müssen, und aus derselben Messung ergibt sich für diesen Fall eine Dauer von rund 50 Minuten, bis das Netzwerk zum großen Teil ruhig war. Zehn Minuten davon sind allein dem Default-Bantime geschuldet: Bei fail2ban steht bantime standardmäßig auf 10 Minuten. Wer nach zehn Minuten wiederkommt, hat es nicht schwer.
Fünfzig Minuten gegen unter fünf Minuten ist ein Unterschied, der nicht durch Feintuning verschwindet. Es ist der Unterschied zwischen "Muster zählen" und "wissen, wen man vor sich hat".
Architektur: Detection und Remediation getrennt
Der zweite Grund, warum CrowdSec in meinem Umfeld schneller gewachsen ist als fail2ban, ist eine Architekturentscheidung, die anfangs banal klingt und im Betrieb viel vereinfacht. CrowdSec trennt die Erkennung von der Durchsetzung. Der Agent, die Security Engine, beobachtet Logs und entscheidet. Der Bouncer setzt die Entscheidung dort um, wo sie weh tut.
Der Bouncer setzt die Regeln
Bouncer gibt es für nftables und iptables, für nginx, für Cloudflare und für eine ganze Reihe weiterer Ziele. Das bedeutet erstens, dass derselbe Agent eine Firewall-Regel und eine Web-Application-Regel gleichzeitig befeuern kann, und zweitens, dass Erkennung auf einem Host laufen kann, während der Ban auf mehreren Hosts greift. In meinem Pool läuft der Agent auf dem Server, der ohnehin die zentrale Log-Sammlung hat, und die beiden Web-Server ziehen ihre Entscheidungen von dort.
Wer diesen Weg plant, sollte sich mit nftables auskennen, denn der Bouncer schreibt am Ende Regeln in die gleiche Tabelle, in der auch alles andere landet. Ich habe die Grundlagen dazu in nftables statt iptables aufgeschrieben, weil es überraschend oft die Stelle ist, an der ein neues Regelwerk mit bestehenden Ketten kollidiert.
cscli statt Regex-Dschungel
Was im Alltag am angenehmsten ist: Die Steuerung läuft über cscli, ein einzelnes Kommandozeilenwerkzeug, das Ban-Listen anzeigt, Entscheidungen manuell setzt, Szenarien prüft und die Verbindung zur Central API zeigt. In der Praxis heißt das, dass ich nicht mehr in fünf INI-Dateien nach einem Filter suche, sondern mit einem Befehl sehe, warum eine IP gebannt ist. In der Konfiguration bedeutet es YAML statt regex-lastiger INI, und das ist nicht nur Geschmackssache: Ein YAML-Szenario beschreibt Verhalten, das man lesen und prüfen kann, eine Failregex beschreibt nur, welche Zeichenfolge zählen soll.
Was der Betrieb wirklich kostet
Bevor das hier nach einer einseitigen Empfehlung klingt: CrowdSec ist kein Ersatz für fail2ban, und es gibt harte Gründe, bei fail2ban zu bleiben. Man muss sie nur kennen, statt sie im Nachhinein zu entdecken.
RAM, ausgehendes HTTPS und air-gapped Netze
Der Ressourcenbedarf ist der erste Punkt. fail2ban läuft ab etwa 512 MB RAM auf einer kleinen Kiste problemlos mit. CrowdSec setzt in meiner Erfahrung eher ab etwa 1 GB RAM an, weil Parser, Szenarien und die eigene Datenhaltung mehr Platz brauchen. Auf einem 1-GB-VPS mit einer Datenbank, einem Webserver und einem Mail-Stack ist das kein Detail, sondern eine Entscheidung darüber, ob man einen größeren Vertrag braucht.
Der zweite Punkt ist gewichtiger. CrowdSec braucht ausgehendes HTTPS zur api.crowdsec.net, um die Community-Signale zu bekommen und die eigenen Bans zu teilen. Das ist bei jedem normalen Server unproblematisch, aber es gibt Umgebungen, in denen es das nicht ist: Netze mit Whitelist-Firewall, industrielle Umgebungen, Kundennetze mit Vertraulichkeitsauflagen, Testlabore ohne Internet. In einem air-gapped Netz bleibt fail2ban die vernünftige Wahl, ganz unabhängig davon, wie schön CrowdSec wäre. Man kann in solchen Fällen mit einer lokalen API und manuell eingespielten Blocklisten arbeiten, aber dann schaltet man genau die Funktion ab, für die man gewechselt wäre.
Die Fallstricke, über die niemand schreibt
Die folgenden drei Punkte haben in meinem Umfeld mehr Betriebszeit gekostet als jede fehlerhaft konfigurierte Regel. Sie betreffen ausdrücklich beide Werkzeuge.
Whitelisting: das eigene Monitoring, das sich selbst aussperrt
Der Whitelist-Eintrag ist die wichtigste Zeile jeder solchen Konfiguration, und sie wird am häufigsten vergessen. In meinem Fall war es der Überwachungshost, der sich durch reine TCP-Checks auf Port 22 selbst gebannt hat. Klassische Kandidaten sind außerdem das eigene Monitoring, der Backup-Runner, der nächtlich per SSH seine Sicherungen abholt, die CI-Runner, die aus einem festen Netz ihre Deployments einspielen, und die eigene Ausgangs-IP, von der aus man per SSH arbeitet.
Der Fehler ist dabei fast nie die Menge, sondern die Form. Ein Whitelist-Eintrag auf eine einzelne IP ist eine Zeitbombe, weil die Adresse in den meisten Netzen nicht stabil ist. Wer sein Büro an einem Anschluss mit dynamischer Adresse hat, sollte nicht seine aktuelle Adresse eintragen, sondern das gesamte Adressband des Anbieters, und dazu braucht man eine saubere Netzberechnung. Genau dafür ist der Subnetz-Rechner auf bitcalc da: Aus einer Adresse und einer Maske wird die Range mit Netz- und Broadcast-Adresse, und man trägt einmal das Netz ein statt jeden Monat eine neue Einzel-IP. Bei beiden Werkzeugen ist das Whitelisting im Übrigen die einzige Konfiguration, die man wirklich testen muss, bevor man sie braucht. Mein Test dafür ist unspektakulär: Nach dem Setzen der Whitelist lasse ich denselben Check laufen, der mich vorher ausgesperrt hat, und schaue mir an, ob in der Ban-Liste noch etwas Neues auftaucht.
Bans sind CIDR-Blöcke, keine Einzel-IPs
Der zweite Fallstrick ist ein Verständnisproblem. Beide Systeme bannen heute nicht nur eine einzelne Adresse, sondern häufig ein ganzes Netz, aus dem der Angriff kommt. Das ist gewollt, weil der Angreifer sonst einfach die letzte Stelle seiner IP wechselt, und es ist selten ein Problem, solange die betroffenen Netze nicht die eigenen sind. Genau dort wird es unangenehm: Ein Ban über ein /24 oder größer kann bei falsch berechneter Whitelist das eigene Büro, das eigene Monitoring oder eine Kundenseite mit abdecken.
Deswegen schaue ich mir vor jedem Whitelist-Eintrag die Breite des Netzes an, das ich freigebe, und prüfe, ob es bei einem Ban in derselben Größenordnung liegt. Der Subnetz-Rechner zeigt dabei nicht nur die Range, sondern auch, wie viele Adressen ein Ban überhaupt treffen kann, und das relativiert die Zahl "ein Ban" sehr schnell. Wer das einmal durchgerechnet hat, formuliert Whitelists deutlich sorgfältiger.
Ban-Zeiten sind heute behavioral
Der dritte Punkt betrifft die Dauer. Früher war bantime eine Konstante, bei fail2ban steht sie standardmäßig auf 10 Minuten, und man hat sie je Jail hochgesetzt, bis es gepasst hat. Heute ist die Ban-Dauer in beiden Systemen meist behavioral gesteuert: Ein Ersttäter wird kurz gesperrt, ein Wiederholungstäter deutlich länger, und die Sperre wächst mit jedem Rückfall. Das ist die richtige Entwicklung, sie macht aber das Nachvollziehen im Betrieb komplizierter, weil nicht mehr eine Zahl in der Konfiguration erklärt, wie lange eine bestimmte IP tatsächlich draußen bleibt.
Um hier nicht im Nebel zu stochern, vergleiche ich bei Verdachtsfällen die Log-Zeitstempel der ersten auffälligen Zeile mit dem Zeitpunkt des Bans. Genau dabei hilft der Zeitstempel-Konverter: Er macht aus Sekundenwerten lesbare Zeit und zurück, sodass man sieht, wie lange der Ban schon zurückliegt und ob ein erneuter Rückfall zur erwarteten Verlängerung geführt hat. Ohne diese Korrelation redet man über Eindrücke statt über Zeiträume.
Entscheidungsmatrix: die beiden im direkten Vergleich
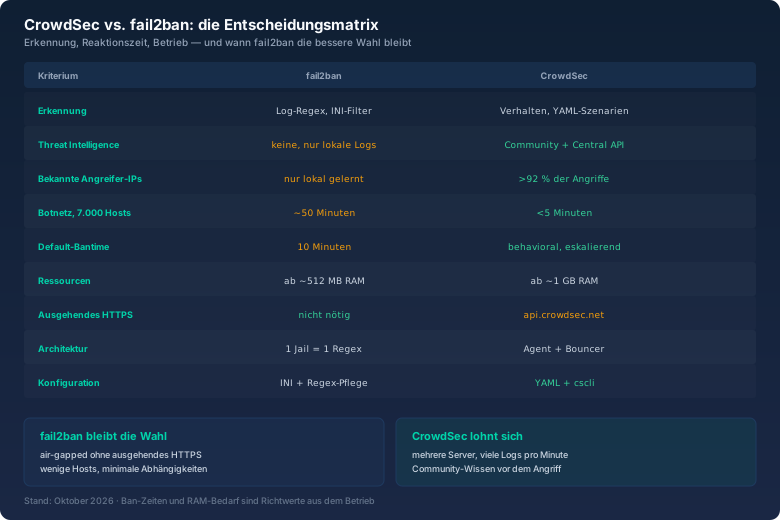
Die Matrix macht das Muster sichtbar. CrowdSec gewinnt überall dort, wo Wissen über den Angreifer zählt: Threat Intelligence, bekannte Adressen, Reaktionszeit beim Botnetz, Ban-Dauer und die Trennung von Agent und Bouncer. fail2ban gewinnt in den Kategorien, die man leicht übersieht: kein ausgehender Datenverkehr, weniger Arbeitsspeicher und minimale Abhängigkeiten.
Zwei Zeilen verdienen besondere Aufmerksamkeit. Die erste ist das ausgehende HTTPS: Für CrowdSec ist der Weg zur Central API kein optionales Extra, sondern der Kern der Sache. Wo dieser Weg versperrt ist, verliert CrowdSec seinen größten Vorteil. Die zweite ist der RAM-Bedarf: Auf kleinen VPS ist fail2ban nicht die schlechtere, sondern die realistischere Wahl.
Was ich wann nehme
Aus der Matrix und meinen eigenen Vorfällen ergibt sich eine Zuordnung, die ich in der Praxis seit zwei Jahren so fahre.
Auf einem einzelnen kleinen Server, auf dem ohnehin alles knapp ist, bleibt fail2ban. Ein Jail für sshd, ein sinnvoller bantime, ein Whitelist-Eintrag für das Monitoring, und die Sache ist erledigt. Der Aufwand für den Betrieb von CrowdSec wäre hier größer als der Gewinn.
In einem Netz ohne ausgehenden Internetzugang, in einem Kundennetz mit Auflagen oder in einem Testlabor ohne Internet bleibt fail2ban ebenfalls. Hier ist es keine Notlösung, sondern die einzige Wahl, die ohne Verrenkungen funktioniert. CrowdSec könnte man installieren, aber man würde die Community-Liste nicht erreichen und damit den Kern des Werkzeugs nicht nutzen.
Überall dort, wo mehrere Server zusammenarbeiten und Log-Mengen anfallen, nehme ich CrowdSec. Auf dem Web-Pool, auf dem Mail-Gateway und auf allem, was nach außen offen ist, läuft der Agent, und die Bouncer verteilen die Entscheidungen dorthin, wo sie gebraucht werden. Der Gewinn kommt nicht aus einer einzelnen besseren Regel, sondern daraus, dass ein Ban auf einem Host sofort auf allen gilt und dass fremde Erkenntnisse vor meiner ersten Logzeile ankommen.
Und die Kombination? Die ist erlaubt und wird von CrowdSec selbst beschrieben, wenn auch nur für Übergangsphasen sinnvoll. Wer fail2ban behalten will, um sich langsam heranzutasten, kann beide nebeneinander laufen lassen, muss dann aber die Whitelists doppelt pflegen und darauf achten, dass sie sich nicht gegenseitig die Ban-Liste leeren. Ich habe das drei Monate so gefahren und danach das fail2ban-Jail für sshd abgeschaltet, weil es nur noch doppelte Arbeit gemacht hat.
Fazit: Zwei Werkzeuge, zwei Aufgaben
fail2ban ist kein altes Werkzeug, das man hinter sich lässt. Es ist ein präziser, abhängigkeitsfreier Regelauswerter, der genau dann die richtige Wahl ist, wenn man keinen ausgehenden Verkehr will, wenig Speicher hat oder ein einzelnes Jail für einen einzelnen Dienst braucht. Es hat mir zehn Jahre lang Brute Force vom Hals gehalten.
CrowdSec löst ein anderes Problem. Es erweitert die Erkennung um Verhalten und die eigene Sicht um das Wissen anderer. Die 92 % bekannten Angreifer-IPs und die unter fünf Minuten im Botnetz-Fall kommen nicht aus besserer Forensik, sondern aus der Entscheidung, nicht mehr allein zu verteidigen. Wer mehrere Server betreibt, gewinnt mit dieser Entscheidung sehr viel Zeit, die er sonst mit Log-Arbeit verbringt.
Wer beides nicht will, muss sich trotzdem um das Whitelisting kümmern. Mein Monitoring hat mir das im Frühjahr erklärt. Und die Lehre daraus ist nicht, dass fail2ban schlecht ist, sondern dass ein automatisches Bann-System immer nur so gut ist wie seine Ausnahmeliste.