Dienstag, 02:47 Uhr. Ich sitze im Wohnzimmer, der Laptop steht auf dem Couchtisch, und ich will eine neue IP-Adresse in die Whitelist meiner Firewall aufnehmen. Ein Freund hat den Provider gewechselt, sein Adressbereich ist ein anderer geworden. Eigentlich eine Fünf-Minuten-Aufgabe: Datei öffnen, Regel ergänzen, Skript ausführen. Stattdessen sitze ich zwanzig Minuten später im Keller vor einem Monitor, der an die Konsole des Servers angeschlossen ist, und frage mich, wie meine Firewall in einen Halbzustand geraten konnte.
Das Skript hieß /etc/firewall.sh und war gewachsen, wie solche Skripte eben wachsen. Es begann mit iptables -F, um alle Ketten zu leeren. Danach kamen 47 Zeilen Regeln: zuerst die Whitelist als fünfzehn einzelne -s-Regeln, dann die Dienste, ganz am Ende ein -A INPUT -j DROP als Auffangnetz. Eine dieser Zeilen hatte ich in dieser Nacht neu geschrieben, und darin steckte ein Tippfehler. Statt der Netzmaske 255.255.255.192 stand dort 255.255.255.0. Im Kopf gerechnet, natürlich. iptables quittierte das mit einer Fehlermeldung, und weil das Skript mit set -e lief, brach es genau an dieser Stelle ab. Regel 37 von 47 wurde nie ausgeführt. Die Ketten waren geleert, die Whitelist-Regeln davor waren geladen, aber alles danach fehlte, inklusive des DROP am Ende. Die Standard-Policy war ACCEPT. Mein Server stand ab 02:47 ohne jede Firewall im Netz.
Zehn Minuten, bis ich es bemerkte. Nichts ist passiert, ein Homelab in einem Wohngebiet ist kein besonders attraktives Ziel. Aber mir wurde klar: Das Problem war nicht der Tippfehler. Das Problem war ein System, das überhaupt in einen Halbzustand geraten konnte. Eine Firewall sollte entweder komplett aktiv sein oder gar nicht. Seit dieser Nacht läuft auf dem Server nftables. Genau darum geht es in diesem Artikel: um den Umstieg von einem 47-Zeilen-iptables-Skript auf eine nftables-Regelsammlung, um Sets, um die inet-Familie, um atomare Reloads und um Zähler, die mir zeigen, was wirklich durch die Leitung fließt.
Was nftables anders macht: eine Tabelle für alles
nftables ist seit Kernel 3.13 (Januar 2014) Teil des Linux-Kernels und der offizielle Nachfolger des iptables-Frameworks. Der wichtigste Unterschied sitzt in der Architektur. iptables verteilt die Filterlogik auf vier verschiedene Werkzeuge: iptables für IPv4, ip6tables für IPv6, arptables für ARP und ebtables für Bridging, jedes mit eigener Syntax und eigenen Tabellen. nftables fasst das in ein einziges Kommando, nft, und eine einzige, konsistente Regelsprache zusammen.
Das Herzstück ist die Adressfamilie. Eine Tabelle vom Typ inet behandelt IPv4 und IPv6 gleichzeitig: Ein table inet filter enthält Ketten, die für beide Protokollfamilien gelten. Vorher hatte ich für IPv4 die 47 Regeln in iptables und für IPv6 eine separate Datei mit zwölf Regeln, die drei Jahre alt war und im Wesentlichen nur SSH erlaubte. Anders gesagt: Mein IPv6-Stack war praktisch offen, und ich wusste es nicht einmal genau. Mit inet gibt es diese Zweigleisigkeit nicht mehr. Eine Regel gilt für beide Welten, oder man sagt explizit, dass sie nur für eine gelten soll.
Dazu kommt die Datenstruktur. Wo iptables Regeln linear ablegt, kennt nftables Sets: benannte Mengen, die man einmal definiert und dann in beliebig vielen Regeln referenziert. Das klingt unspektakulär, ist aber der Grund, warum meine Whitelist von fünfzehn Einzelregeln auf vier Set-Elemente geschrumpft ist. Mehr dazu in einem eigenen Abschnitt.
Das alte Setup: 47 Regeln, sechs Ketten, null Zähler
Damit die Zahlen hier nicht im Leeren stehen, hier das alte Setup im Überblick. Der Server ist ein kleiner Homelab-Kasten, ein Ryzen mit 16 GB RAM, der als Fileserver, Medienserver und gelegentliche VM-Kiste dient. Er hängt an einem Router, der die Ports 22, 80, 443 und 51820/UDP nach innen reicht. Die Firewall auf dem Server selbst ist der letzte Filter vor den Diensten.
Das iptables-Skript hatte 47 Regeln in sechs Ketten verteilt. Fünfzehn davon waren Whitelist-Einträge: -A INPUT -s 192.168.10.0/24 -j ACCEPT, gefolgt von vierzehn weiteren Zeilen derselben Bauart. Dazu kamen die Dienst-Regeln, ein paar Ausnahmen für etablierte Verbindungen und der finale DROP. Sechs Ketten, weil sich im Laufe der Jahre mangle- und nat-Reste eingeschlichen hatten, die niemand mehr richtig zuordnen konnte. Aufgeräumt hat sie auch niemand, weil iptables keinen eingebauten Weg bot, die tatsächlich aktiven Regeln mit der Datei auf der Platte abzugleichen.
Vor allem aber: keine einzige Regel hatte einen Zähler. Als ich später wissen wollte, wie viel Verkehr auf Port 22 ankommt, blieb nur tcpdump auf dem Interface. Bei einem Server, der 24/7 läuft, ist das, als würde man den Stromverbrauch messen, indem man einmal im Monat kurz auf den Zähler schaut und den Rest der Zeit rät.
# /etc/firewall.sh (Auszug, vor dem Umstieg)
iptables -F
iptables -A INPUT -s 192.168.10.0/24 -j ACCEPT
iptables -A INPUT -s 10.30.0.0/26 -j ACCEPT
... 13 weitere Whitelist-Zeilen ...
iptables -A INPUT -p tcp --dport 22 -j ACCEPT
iptables -A INPUT -p tcp --dport 80 -j ACCEPT
iptables -A INPUT -p tcp --dport 443 -j ACCEPT
iptables -A INPUT -p udp --dport 51820 -j ACCEPT
iptables -A INPUT -j DROP
Sechs Ketten, 47 Regeln, null Zähler, und ein Reload, der bei jedem Lauf erst alles löschte und dann neu aufbaute. Scheiterte das Skript in der Mitte, war der Server ohne Schutz. Genau das war die Nacht im Februar.
Der Umstieg: eine Datei, drei Ketten, zwei Sets
Die neue Regelsammlung liegt in /etc/nftables.conf und ist am Ende ein Bruchteil des alten Skripts. Eine Tabelle vom Typ inet, drei Basis-Ketten, zwei benannte Sets. Der Rest ist Lesbarkeit.
#!/usr/sbin/nft -f

table inet filter {
  set whitelist {
    type ipv4_addr
    flags interval
    elements = { 192.168.10.0/24, 10.30.0.0/26,
                 100.64.0.0/10, 172.16.42.0/24 }
  }
  set services {
    type inet_service . inet_proto
    elements = { 22 . tcp, 80 . tcp, 443 . tcp,
                 51820 . udp }
  }

  chain input {
    type filter hook input priority filter; policy drop;
    counter packets 0 bytes 0
    ct state established,related accept
    ip saddr @whitelist accept
    tcp dport @services accept
    udp dport @services accept
    counter
  }

  chain output {
    type filter hook output priority filter; policy accept;
    counter
  }

  chain forward {
    type filter hook forward priority filter; policy drop;
    counter
  }
}
Sieht anders aus als das alte Skript, und das hat gute Gründe. Die Whitelist ist jetzt ein Set mit vier Einträgen statt fünfzehn Einzelregeln. Weil das Set mit flags interval definiert ist, akzeptiert es ganze Bereiche: 192.168.10.0/24 ist ein Element, keine Maske, die ich mir merken muss. Der Dienstesatz nutzt eine Verkettung: inet_service . inet_proto heißt, jedes Element ist ein Paar aus Port und Protokoll. 22 . tcp ist etwas anderes als 22 . udp, und trotzdem bleibt die Regel tcp dport @services accept eine einzige Zeile.
Die Ketten heißen offen input, output und forward, mit den Hooks dahinter in Klammern. Jede Basis-Kette bekommt eine Policy. Bei input und forward ist sie drop, bei output accept. Das ist die Umkehrung der alten Logik: Statt am Ende einen DROP anzuhängen, ist das Verwerfen jetzt der Grundzustand, und jede Regel öffnet bewusst ein Loch. Wer vergisst, eine Regel zu schreiben, hat am Ende eine geschlossene Firewall, keine offene.
Die Hooks: wo die Pakete wirklich langlaufen
Wer iptables gewohnt ist, kennt die Ketten INPUT, OUTPUT und FORWARD. nftables macht sichtbar, was dahintersteckt: Der Kernel ruft an fünf festen Punkten im Netzwerkstack Funktionen auf, die Netfilter-Hooks. Ein Paket, das von außen kommt, durchläuft zuerst PREROUTING. Danach entscheidet das Routing, ob es lokal zugestellt wird (dann INPUT) oder weitergereicht wird (dann FORWARD). Verkehr, den der Server selbst erzeugt, startet in OUTPUT. Alles, was den Rechner verlässt, passiert am Ende POSTROUTING.
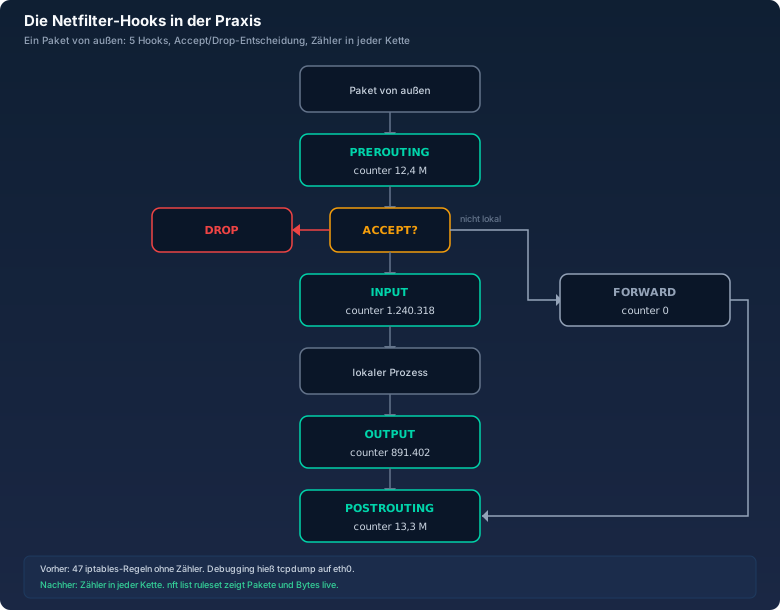
Die Grafik zeigt den Durchlauf mit den Zählerständen nach dreißig Tagen Laufzeit. PREROUTING hat in dieser Zeit 12,4 Millionen Pakete gesehen, INPUT nur 1.240.318. Die Differenz ist der Teil, den die Firewall verworfen hat: Port-Scans, Bots, Broadcast-Geräusche. FORWARD steht bei null, weil der Server kein Router ist. OUTPUT liegt bei 891.402 Paketen, dominiert von Backups und Updates. POSTROUTING summiert OUTPUT und FORWARD, also rund 13,3 Millionen.
Diese Zahlen waren mit iptables nicht zu bekommen, jedenfalls nicht ohne jede einzelne Regel um einen Zähler zu erweitern. In nftables ist counter ein Schlüsselwort, das man an jede Regel hängen kann. Die nackte Zeile counter am Ende der input-Kette zählt alles, was bis dahin nicht akzeptiert wurde, also den verworfenen Rest. nft list ruleset zeigt die Zählerstände in Sekunden, und wer mag, hängt ein Monitoring an nft list counters.
Atomarer Reload: der Unterschied zwischen Nacht und Tag
Zurück zur Nacht im Februar. Das eigentliche Problem war nicht der Tippfehler, sondern dass ein Fehler mitten im Ladevorgang einen Halbzustand hinterließ. Genau das kann mit nft -f nicht passieren. nftables baut die komplette Regelsammlung erst im Speicher auf, validiert sie und aktiviert sie dann in einem einzigen Schritt. Entweder gilt die neue Regelsammlung komplett, oder es gilt weiterhin die alte. Einen Zwischenzustand gibt es nicht.
Dazu kommt nft -c (check): Damit lässt sich eine Datei prüfen, ohne sie anzuwenden. nft -c -f /etc/nftables.conf meldet Syntaxfehler, unbekannte Namen und falsche Typen, bevor auch nur ein Paket betroffen ist. Mein Workflow ist seitdem: Datei editieren, nft -c -f ausführen, und erst wenn das grün ist, systemctl reload nftables. Der alte Ablauf dauerte rund sieben Sekunden, weil jede der 47 iptables-Zeilen einen eigenen Prozess startete. Der Reload mit nftables ist nach wenigen Millisekunden durch. Sieben Sekunden gegen Millisekunden, und der eine Weg ist sicher, der andere nicht.
Ein Detail noch, weil es die meisten Umsteiger erwischt: nft flush ruleset löscht wirklich alles, auch die eigene SSH-Regel. Wer das von Hand über eine SSH-Session ausführt, hat die Tür hinter sich zugezogen. In der Datei ist das unkritisch, weil der Reload atomar ist und die neue Regelsammlung die SSH-Regel ja wieder enthält. Von Hand, über eine laufende Verbindung, ist es eine der schnellsten Arten, sich aus dem eigenen Server auszusperren. Der alte Reflex aus iptables-Zeiten, erst zu löschen und dann neu aufzubauen, ist in nftables nicht nur unnötig, er ist aktiv gefährlich.
Sets in der Praxis: warum die Whitelist im Subnetz-Rechner endete
Der eigentliche Gewinn des Umstiegs sind die Sets, und der zeigt sich im Alltag. Eine neue IP in die Whitelist aufnehmen heißt seitdem: nft add element inet filter whitelist { 10.30.0.64/26 }, fertig. Kein Editieren einer Skriptdatei, kein Reload, keine Prozessspawns. Das Set ist live, die Regel, die es referenziert, bleibt unverändert. Und weil der Eintrag ein CIDR-Block ist, deckt eine Zeile gleich ein ganzes Subnetz ab, wenn der Freund eben keinen einzelnen Host, sondern einen Adressbereich seines Providers bekommen hat.
Genau da hat sich der bitcalc Subnetz-Rechner wieder in meinen Alltag geschlichen. Die Februar-Nacht war im Grunde ein Netmasken-Problem: 255.255.255.192 ist die Maske eines /26, 255.255.255.0 die eines /24. Wer solche Werte im Kopf rechnet, macht früher oder später genau diesen Fehler. Seitdem rechne ich jeden Bereich, bevor er in ein Set wandert: Wie viele Hosts passen in das /26 des Freundes? Überschneidet sich 10.30.0.0/26 mit dem Tunnelnetz 100.64.0.0/10 aus der VPN-Geschichte? Der Subnetz-Rechner zeigt Netzadresse, Hostbereich, Broadcast und Größe auf einen Blick, und die Überlappungsprüfung von Hand ist damit obsolet. Das Set whitelist enthält inzwischen vier Elemente, und jedes davon habe ich vorher durch den Rechner gejagt.
Einen weiteren Vorteil der Sets merkt man erst im Betrieb: Die Regel ip saddr @whitelist accept ist eine einzige Zeile, egal ob das Set vier oder vierhundert Einträge hat. Beim alten Skript wuchs die Whitelist um eine Zeile pro Eintrag, und irgendwann fragt man sich, ob da nicht doch irgendwo eine veraltete IP steht. Beim Set ist die Antwort eine Abfrage: nft list set inet filter whitelist.
Zähler als Diagnosewerkzeug
Der größte unsichtbare Gewinn sind die Zähler. Ich hatte keine Ahnung, wie viel von dem, was an meinem Server ankommt, überhaupt gewollt ist, bis die Zahlen auf dem Tisch lagen. Die 12,4 Millionen Pakete in PREROUTING gegen 1.240.318 in INPUT heißen: Rund 90 Prozent des eingehenden Verkehrs wird verworfen. Davon ist der Großteil Port-Scan-Rauschen, aber es gab auch eine Überraschung. Die Zähler der input-Kette zeigten einen stetigen Strom von Paketen auf Port 445, also SMB. Von außen. Mein Server bietet gar kein SMB an, und der Router sollte diesen Port auch gar nicht hereinreichen. Ergebnis der Nachforschung: ein vergessener Port-Forward aus der Zeit, als ich Windows-Freigaben experimentell getestet hatte. Die Regel stand drei Jahre in der Router-Konfiguration, und niemand hat sie gebraucht. Ohne Zähler hätte ich das nie gesehen, weil nichts kaputt war. Es war nur sinnlos offen.
Seitdem schaue ich einmal im Monat auf die Zählerstände, so wie man auf den Stromzähler schaut. Fünf Minuten, nft list ruleset, und ich weiß, ob sich etwas geändert hat. Wenn plötzlich ein Dienst mehr Verkehr sieht als sonst, ist das ein Hinweis, bevor es ein Problem wird.
Was beim Umstieg hakt: drei Stolpersteine
Fairerweise: Der Umstieg hat auch wehgetan. Drei Dinge haben mich am meisten Zeit gekostet.
Erstens die Syntax. nftables ist eine eigene Sprache, keine iptables-Variante. -A INPUT -p tcp --dport 22 -j ACCEPT wird zu tcp dport 22 accept. Das liest sich nach zwei Tagen natürlicher als die alte Flaggen-Suppe, aber die ersten Stunden sind mühsam. Die Manpage und nft -c sind dabei die besten Freunde.
Zweitens NAT. Für Masquerading braucht nftables eine eigene Tabelle vom Typ ip, weil die inet-Tabelle für NAT-Eingriffe je nach Kernelversion nicht zuverlässig funktioniert. Wer seinen Router umstellt, stolpert hier zuverlässig. In meinem Fall hat der Router das NAT gemacht und der Server nur gefiltert, also war die Sache einfach. Wer beides auf einer Kiste hat, plant die nat-Tabelle von Anfang an ein.
Drittens die Prioritäten. Basis-Ketten hängen an einem Hook mit einer Prioritätszahl, und die Reihenfolge der Tabellen entscheidet, wer zuerst sieht. Standard-Filtertabellen laufen mit Priorität 0, und solange man nur eine Tabelle hat, ist die Sache einfach. Sobald eine zweite Tabelle ins Spiel kommt, etwa für ein IDS, muss man die Prioritäten kennen, sonst sieht die eine Tabelle Pakete, die die andere schon verworfen hat.
Fazit
Ein Jahr nach der Februar-Nacht ist die Bilanz eindeutig. 47 iptables-Regeln in sechs Ketten sind zu einer Tabelle mit drei Ketten und zwei Sets geworden. Der Reload, der früher sieben Sekunden dauerte und kaputtgehen konnte, ist ein atomarer Schritt von wenigen Millisekunden, und nft -c fängt Fehler, bevor sie Wirkung entfalten. Die Whitelist ist von fünfzehn Einzelregeln auf vier Set-Elemente geschrumpft, IPv4 und IPv6 teilen sich eine Regelsammlung, und jeder Hook zählt mit.
Am wichtigsten ist aber das Gefühl, das man nicht messen kann: Die Firewall kann nicht mehr in einen Halbzustand geraten. Das Skript aus der Februar-Nacht liegt noch auf der Platte, als Erinnerung. Ab und zu öffne ich es und schaue mir Zeile 37 an, die mit der falschen Netzmaske. Inzwischen rechne ich jede Maske mit dem bitcalc Subnetz-Rechner durch, bevor sie irgendwo landet. Und die Regel selbst steht längst als Set-Element in einer nftables-Datei, die sich nicht mehr in der Mitte verabschieden kann.