Ich habe im Oktober eine SSD aus einem Kunden-NAS gezogen, die laut SMART noch 96 % ihres Lebens vor sich hatte. Sie war drei Monate später tot. Nicht langsam sterbend, nicht mit Vorwarnung — tot. Der Server hat beim Schreiben Fehler geworfen, das Dateisystem ging auf read-only, und die Auswertung zeigte, was ich hätte früher prüfen sollen: Die 96 % waren der Verbrauch der P/E-Zyklen, und der war niedrig, weil der Controller clever verschob. Was daneben stand und niemand angesehen hatte, war die Menge der tatsächlich geschriebenen Bytes. Sie lag über der TBW-Angabe des Herstellers.
Genau daran hängt die ganze Verwirrung um das Thema. Eine Prozentzahl ohne Bezugsgröße ist keine Lebensdauerprognose, sondern ein Datenpunkt. Dieser Artikel ist die Rechnung, die ich seitdem mache, bevor eine SSD irgendwo eingebaut wird.
Was SMART wirklich zählt
Der Wert, den Windows, das NAS-Webinterface oder smartctl als „Life Left" oder „Percentage Used" anzeigt, ist meist über einen von zwei Wegen entstanden, und beide haben ihre Grenze.
Der erste Weg ist die Zählung der P/E-Zyklen. Jede Löschoperation nutzt einen Flash-Block ab, und der Controller zählt mit, wie oft er jeden Block beschrieben und gelöscht hat, gewichtet über alle Blöcke. Aus dem Verhältnis der verbrauchten zu den spezifizierten Zyklen entsteht die Prozentzahl. Das ist ehrlich gerechnet, aber es beschreibt nur den NAND, nicht die Arbeit, die der Rechner ihm aufbürdet. Genau deshalb kann eine SSD mit 96 % Restleben sterben: Wenn die Schreiblast so hoch ist, dass die spezifizierte Gesamt-Schreibmenge erreicht wird, während die P/E-Zyklen noch Reserven haben, ist die Angabe richtig — und trotzdem täuscht sie über die Restlaufzeit.
Der zweite Weg stammt von SSDs, die keine P/E-Daten mehr sauber pflegen, und schätzt den Verbrauch aus der geschriebenen Datenmenge ab. Beide Wege sagen dir im Kern dasselbe: Die interessante Zahl ist nicht der Prozentsatz, sondern die Menge der geschriebenen Bytes, verglichen mit der Spezifikation.
TBW, DWPD, PBW — drei Namen für dieselbe Größe
Alle drei beschreiben, wie viel Schreibvolumen eine SSD verträgt, bevor der Hersteller die Garantie beendet. Sie sind verschieden ausgedrückt, weil sie für unterschiedliche Zielgruppen gedacht sind.
TBW — Total Bytes Written
TBW heißt „so viele Terabyte darfst du schreiben". Eine Consumer-SATA-SSD mit 1 TB hat typisch 600 TB TBW. Eine NVMe mit 2 TB liegt bei 1.200 TB, eine Enterprise-SSD mit 1,92 TB bei 3.500 TB oder mehr. Der Wert steht im Datenblatt, nicht auf der Verpackung, und er ist die Grundlage für alles Weitere.
DWPD — Drive Writes Per Day
DWPD ist die Angabe, die aus dem Rechenzentrum kommt: Wie oft darf man die volle Kapazität der SSD pro Tag überschreiben, über die Garantiezeit gerechnet? Ein DWPD von 1 auf einer 1,92-TB-SSD bedeutet also: 1,92 TB pro Tag, über die Garantiezeit. Der Vorteil dieser Einheit ist, dass sie die Kapazität mitdenkt — deshalb sind Enterprise-SSDs in DWPD vergleichbar und Consumer-SSDs nicht.
Die Umrechnung zwischen beiden ist der Punkt, an dem ich in Gesprächen am häufigsten sehe, dass jemand zwei Zahlen vergleicht, die dieselbe Sache meinen. Die Formel lautet:
DWPD = TBW ÷ (Kapazität in TB × Garantiejahre × 365)
Für die 1-TB-Consumer-SSD mit 600 TB TBW und fünf Jahren Garantie ergibt das 600 ÷ (1 × 5 × 365) = 0,33 DWPD. Für die 1,92-TB-Enterprise-SSD mit 3.500 TB TBW: 3.500 ÷ (1,92 × 5 × 365) ≈ 1,0 DWPD. Die Enterprise-SSD schreibt also pro Kapazitätseinheit dreimal so viel — und kostet dafür auch entsprechend. Umgekehrt gerechnet bekommst du aus DWPD das PBW zurück: 1,92 TB × 1 DWPD × 5 Jahre × 365 = 3.504 TB ≈ 3,5 PB.
Wer PBW liest, meint dasselbe in Petabyte. Für Größenordnungen über 1.000 TB ist das die angenehmere Einheit, aber verwechsle sie nicht mit der Größe der Platte: Eine SSD mit 4 TB TBW ist nicht 4 TB groß, sie ist 1 TB groß und darf 4 TB schreiben. Das ist der Klassiker unter den Datenblatt-Missverständnissen.
Write Amplification: warum die SSD mehr schreibt als du
Wenn du 100 GB auf eine SSD schreibst, kommen nicht 100 GB im NAND an, sondern mehr. Der Controller muss vor dem Schreiben ganze Blöcke löschen, und er muss Daten umschichten, wenn nur ein Teil eines Blocks geändert wurde. Das Verhältnis von tatsächlich in den Flash geschriebenen zu den vom Host angefragten Bytes heißt Write Amplification Factor, kurz WAF. Er liegt im günstigen Fall nahe 1, im unangenehmen Fall bei 4 oder mehr.
Drei Dinge treiben den WAF nach oben, und alle drei sind in der Praxis allgegenwärtig. Erstens kleine zufällige Schreibzugriffe: Eine Datenbank, die in 4-KB-Blöcken arbeitet, zwingt den Controller zu ständigem Umschichten. Zweitens ein fehlendes TRIM: Wenn dem Controller nicht mitgeteilt wird, welche Bereiche frei sind, muss er sie weiter mitschleppen. Drittens Workloads, die eigentlich nicht für Flash gedacht sind: Logs, die permanent angehängt werden, Swap, oder ein ZFS-SLOG auf einer Consumer-SSD, die dafür nie gebaut wurde.
Für die Lebensdauer heißt das: Die TBW-Angabe bezieht sich auf die Bytes, die im NAND landen, nicht auf die, die du vom Host aus schickst. Rechne mit dem WAF, nicht ohne — sonst hält die Platte nur halb oder viertel so lange wie deine Schätzung.
Die Rechnung, die ich wirklich mache
Bevor eine SSD in einen Server kommt, schätze ich drei Zahlen: die tägliche Schreiblast vom Host, den erwarteten WAF und das TBW-Rating. Aus den ersten beiden entsteht die Last im NAND, und die Lebensdauer ergibt sich aus der Division.
Die tägliche Schreiblast abzuschätzen ist der schwierigste Teil, weil sie selten offensichtlich ist. Bei einem Backup-Server ist sie die Menge der Sicherungen. Bei einem Datenbankhost ist sie schlimmer zu greifen, weil sie von den Transaktionen abhängt: eine Schreiboperation pro Datensatz, oft in kleinen Blöcken. Genau dafür nutze ich den IOPS-Rechner: Wenn ich weiß, wie viele Schreib-IOPS eine Last im Mittel erzeugt und wie groß die Blöcke sind, komme ich auf die Byte-Menge pro Tag. Aus 200 Schreib-IOPS mit durchschnittlich 8 KB pro Zugriff werden rund 138 GB pro Tag — 50 TB im Jahr, mit WAF 2,5 sind das 126 TB pro Jahr im NAND.
Rechnen wir das für drei Platten durch, wird sofort klar, warum die Wahl der SSD wichtiger ist als die Wahl des Servers.
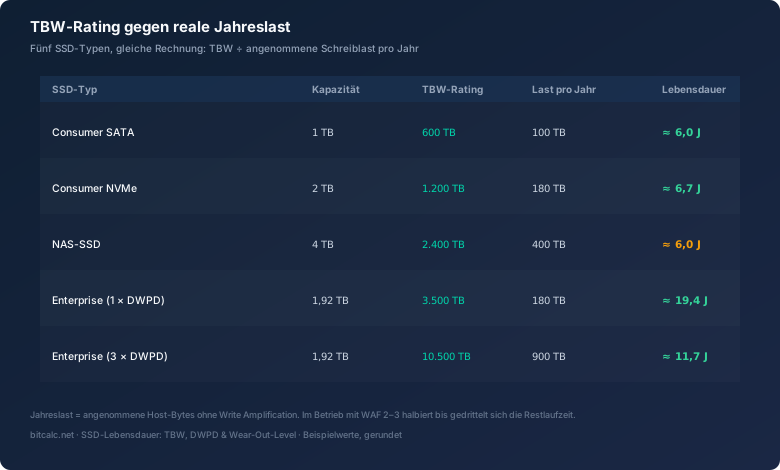
Die Zahlen in der Tabelle sind bewusst gerundet und mit einer Jahreslast gerechnet. Aber sie zeigen das Muster: Dieselbe Last bringt eine Consumer-Platte nach sechs Jahren an ihre TBW-Grenze und eine Enterprise-Platte nicht nach neunzehn. Der Unterschied zwischen beiden liegt nicht in der Zelltechnologie, sondern in der Spezifikation, mit der der Hersteller für die Dauer der Garantie geradesteht.
Wear-Out-Werte richtig lesen
Im NVMe-SMART-Log stehen mehrere Werte, die zusammen ein Bild ergeben, und es lohnt sich, sie nicht einzeln zu betrachten. Der aussagekräftigste ist Data Units Written: die tatsächlich im NAND geschriebene Menge, in 1.000 × 512-Byte-Einheiten. Geteilt durch die TBW-Angabe ergibt das eine Prozentzahl, die näher an der Wahrheit liegt als jedes „Life Left".
Daneben stehen Percentage Used (der Verbrauch, wie der Controller ihn schätzt), Available Spare (Reserveblöcke, die für den Verschleißausgleich vorgehalten werden) und Media Errors (Lesefehler, die per Redundanz korrigiert wurden, ohne dass du es gemerkt hast). Wichtig zu wissen: Kein Hersteller zählt identisch. Eine SSD, die bei 100 % „Percentage Used" als abgeschrieben gilt, läuft oft weiter, weil die Reserveblöcke greifen — und eine SSD, die 0 % meldet und dabei über ihre TBW hinausgeschrieben wird, kann trotzdem plötzlich ausfallen. Beide Extreme habe ich erlebt.
Der pragmatische Ansatz: Data Units Written gegen TBW ins Verhältnis setzen, Percentage Used und Available Spare im Verlauf beobachten, und auf einen Alarm schalten, bevor die Werte ins Rote laufen. Was man im Fall eines Ausfalls tut, steht im Detail in meinem Artikel zu den SMART-Werten, denn die SSD ist nicht das einzige Bauteil, das vorher Bescheid sagt.
Welche Workloads die SSD wirklich töten
Aus fünf Jahren Serverbetrieb kann ich die schreibintensiven Fälle benennen, die Platten zuverlässig aufbrauchen — und es sind fast immer dieselben.
An erster Stelle steht das Logging. Ein Dienst, der bei jedem Request eine Zeile schreibt, kann pro Tag erstaunliche Datenmengen erzeugen. An zweiter Stelle steht die Datenbank mit kleinen Transaktionen, weil sie nicht nur viel schreibt, sondern auch viel umschichtet. An dritter Stelle steht ZFS: Ein SLOG für das ZIL ist eine der klassischen Fallen, weil er genau dann stark belastet wird, wenn die Last am höchsten ist — und wenn er auf einer Consumer-SSD ohne Power-Loss-Protection sitzt, wird er zur vernichtenden Schwachstelle. Zu den Storage-Tiering-Fragen gehört diese Abgrenzung dazu; was wann wohin gehört, steht in Storage-Tiering.
An vierter Stelle steht der Klassiker, den ich selbst erlebt habe: der Cache. Ein L2ARC oder ein Cache-Datenträger auf einer Platte, die über die Jahre vergessen wird. Er schreibt nicht spektakulär viel pro Sekunde, aber er schreibt konstant, und konstant ist über drei Jahre tödlich.
Was die Last tatsächlich senkt
Es gibt drei Maßnahmen, die spürbar etwas bringen, und drei, die nur auf dem Papier wirken.
Was hilft, ist erstens TRIM. Auf Linux ist das der nächtliche fstrim-Durchlauf oder ein discard=async auf modernen Dateisystemen; beides sorgt dafür, dass der Controller weiß, was gelöscht wurde, und den WAF senkt. Zweitens die richtige Platte am richtigen Platz: Der SLOG gehört auf eine Enterprise-SSD mit Power-Loss-Protection, nicht auf die günstigste NVMe. Drittens das Monitoring, das den Verbrauch über die Zeit sichtbar macht — eine SSD, deren Verbrauch man nicht sieht, ist eine SSD, deren Ausfall man nicht kommen sieht.
Was nicht wirkt, ist die Jagd nach größeren Kapazitäten allein: Eine 8-TB-Consumer-SSD hat nicht automatisch mehr TBW pro Kapazität, sondern meist denselben Wert pro TB. Ebenso wenig hilft es, das Wear-Out-Level kleiner zu reden, indem man den Prozentsatz statt der geschriebenen Bytes liest. Und der dritte Irrtum ist der Glaube, RAID schütze gegen Verschleiß — es tut das Gegenteil, weil jede Paritätsberechnung zusätzliche Schreiboperationen erzeugt. Was RAID gegen Ausfall schützt, steht im Detail im RAID-Praxisartikel; für die Lebensdauer ist entscheidend, dass die Last pro Platte mit der Anzahl der Platten nicht sinkt, sondern steigt.
Fazit
Die SSD im Kunden-NAS hat kein Montagsmodell erwischt und ist nicht durch einen Produktionsfehler gestorben. Sie hat über drei Jahre genau das getan, was man ihr aufgetragen hat, und ist irgendwann an der Grenze angekommen, die im Datenblatt stand — nur hatte niemand diese Grenze gegen die tatsächliche Last gerechnet.
Die Lehre daraus ist eine Reihenfolge, die ich seitdem immer einhalte. Erst das TBW-Rating lesen, dann die tägliche Schreiblast abschätzen, dann den WAF dazurechnen, dann die Platte wählen. Wer diese vier Schritte macht, bevor er bestellt, ersetzt später keine Platte, die er hätte ersetzen können. Und der Blick auf die geschriebenen Bytes statt auf das Life-Left-Prozent kostet nichts außer einer Minute Arbeit pro Monat.