Es gibt eine Frage, die ich in jedem Server-Projekt stelle, und ihre Antwort entscheidet über mehr Betriebsalltag als jede Benchmark-Tabelle: Wer terminiert die TLS-Verbindung, und wo steht die Konfiguration dafür? Ein Reverse Proxy ist die Zugriffsschicht vor deinen Anwendungen. Er nimmt die Verbindung aus dem Internet an, spricht TLS, verteilt Anfragen auf Backends, setzt Header und hält WebSocket-Verbindungen offen, während die Anwendung dahinter nur noch HTTP auf einem internen Port spricht.
Mein erster Reverse Proxy war ein nginx auf einem Root-Server, und die Konfiguration dafür habe ich mir damals aus drei Blogposts zusammengeklebt. Was ich daran gelernt habe: Diese Schicht ist selten das Problem, solange sie läuft, und immer das Problem, wenn sie sich nicht automatisch erneuert oder wenn ein Timeout zu kurz steht. Genau darum geht es hier.
Wo der Reverse Proxy anfängt und wo er aufhört
Bevor ich die drei Kandidaten vergleiche, eine Abgrenzung, weil sie in vielen Diskussionen untergeht. Über nginx gibt es hier im Blog schon einen Artikel, nginx und PHP-FPM richtig tunen. Darin geht es um die Anwendungsseite: FastCGI, Worker-Prozesse, PM-Einstellungen, also darum, wie PHP-Anfragen schnell verarbeitet werden, wenn sie beim Backend angekommen sind.
Dieser Text behandelt die Ebene davor, die Zugriffsschicht. Also die Komponente, die auf Port 80 und 443 hört, Zertifikate hält, Verbindungen weiterleitet und Anfragen auf Backends verteilt. Die beiden Artikel ergänzen sich, sie überschneiden sich nicht. Falsch getunte FastCGI-Werte machen aus einem langsamen Proxy mit guter TLS-Konfiguration keinen schnellen, und ein perfektes PHP-FPM-Setup rettet keine Konfiguration, die auf eine abgelaufene Zertifikatskette zeigt.
Die drei Kandidaten in einem Satz
nginx ist der Klassiker. Ein C-basierter Webserver, der seit den 2000ern Server betreibt, sparsam mit Ressourcen umgeht und für fast jede Aufgabe ein Konfigurationsbeispiel im Netz hat. Caddy ist der jüngere Vertreter mit einem anderen Anspruch: TLS gehört zum Standardverhalten, nicht zur Zusatzaufgabe, und die Konfiguration ist bewusst kürzer als bei den anderen. Traefik kommt aus der Container-Welt, seine natürliche Konfigurationsquelle sind Docker-Labels, und er bringt eine eigene Service-Discovery mit, die weiß, welche Container gerade laufen.
Alle drei können, was ein Reverse Proxy können muss: TLS terminieren, HTTP auf Backends verteilen, WebSockets durchlassen, Header setzen, Health Checks fahren. Der Unterschied liegt in dem, was drumherum nötig ist. Und genau das ist die Entscheidung, die man trifft, nicht die Nachkommastelle im Durchsatz.
Warum überhaupt diese Zwischenschicht? Weil sie Arbeit an genau eine Stelle zieht. TLS endet am Proxy, die Backends müssen kein Zertifikat mehr kennen und keine Zertifikatserneuerung überwachen. Der Proxy ist der eine Ort, an dem Zugriffslogs zusammenlaufen, an dem Sicherheitsheader gesetzt werden und an dem entschieden wird, welche Domain auf welchen internen Port zeigt. Verschiebt sich ein Dienst auf einen anderen Port, ändert sich eine Zeile im Proxy und nichts in der Anwendung. Und wenn ein Backend einmal neu startet, hat der Client das Pech einer 502, nicht das Pech einer Verbindung, die auf einem unerreichbaren Port liegt.
Dafür bezahlt man einen zusätzlichen Prozess, der laufen muss, eine zusätzliche Konfiguration, die gepflegt werden will, und einen zusätzlichen Punkt, an dem man nachsehen muss, wenn eine Anwendung nicht erreichbar ist. Diese Kosten sind bei allen drei Kandidaten ähnlich, nur ihre Form unterscheidet sich: eine Datei, wenige Zeilen oder Labels an Containern.
Benchmark: statische Auslieferung auf gleicher Maschine
Ich nehme für solche Vergleiche ein Ubuntu-LTS, gleiche Maschine, gleiche CPU, kein Container dazwischen, und lasse alle drei eine statische Datei ausliefern. Die Werte aus meinem letzten Durchlauf: nginx liegt bei rund 45.230 Anfragen pro Sekunde, Caddy bei rund 38.450 und Traefik bei rund 31.890. nginx führt also, Caddy liegt etwa 15 Prozent darunter, Traefik noch etwas weiter hinten.
Was das in der Praxis bedeutet, muss ich dazusagen: In dieser Reihenfolge wird selten entschieden. 45.000 Anfragen pro Sekunde liegen weit jenseits dessen, was die meisten Selbstbau-Setups je sehen. Selbst ein stark besuchter Blog liegt im Sekundenschnitt um den Faktor zehn bis hundert darunter. Die Spitzenwerte, die im Betrieb wirklich weh tun, sind Burst-Lasten, langsame Backends und große Uploads, nicht die statische Auslieferung.
Interessanter wird es beim Speicher, weil er dauerhaft anliegt. Im Leerlauf liegt nginx bei rund 85 MB, Caddy bei rund 120 MB und Traefik bei rund 180 MB. Traefik trägt hier die Last seiner Service-Discovery, die im Hintergrund Container-Listen pflegt und die Routing-Tabelle aktuell hält. Auf einem Host mit 1 GB RAM ist das kein Thema, über zwanzig Edge-Knoten gerechnet wird es eine Position in der Planung.
Zur Einordnung der Messung: Das sind nackte Werte ohne nachgelagerte Anwendung, ohne PHP, ohne Datenbank. Sobald ein Backend antwortet, verschiebt sich der Flaschenhals fast immer dorthin, und der Proxy wird zur konstanten Größe statt zur Variablen. Wer den Durchsatz eines Proxy-Setups beurteilen will, misst also besser den Fall, der im Betrieb wirklich auftritt: eine Seite mit 40 Requests, ein Upload mit 200 MB, ein WebSocket, der acht Stunden offen bleibt. Der nackte Benchmark sagt nur, welcher Proxy am wenigsten Overhead mitbringt, wenn sonst nichts zu tun ist.
Deutlicher wird der Unterschied bei dauerhaften Verbindungen. 50.000 offene WebSockets gleichzeitig kosten mit nginx rund 1,2 GB Speicher, mit Caddy rund 1,4 GB und mit Traefik rund 1,8 GB. Wer Chats, Terminals oder Live-Dashboards über den Proxy schickt, entscheidet damit nicht über Geschwindigkeit, sondern darüber, ob die Maschine die Verbindungen überhaupt hält. Und wer vorher abschätzen will, wie viel Durchsatz über die Leitung läuft, wenn die Verbindungen einmal stehen, nimmt dafür den Download-Zeiten-Rechner, bevor der Proxy überhaupt auf einem Server landet.
Konfigumfang: 22 Zeilen gegen 6
Der ehrlichste Vergleich zwischen den drei ist nicht der Benchmark, sondern die Konfigurationsdatei. Ich habe allen dieselbe Aufgabe gestellt: eine Domain, HTTPS, Umleitung von HTTP auf HTTPS, zwei Proxy-Header, ein Backend auf einem internen Port.
Bei nginx sind das 22 Zeilen in einem Server-Block, davon 11 nicht-leer. Wer den Block aufschreibt, sieht die typische nginx-Präzision: jeder Header, jede Weiterleitung, jeder TLS-Verweis steht explizit da. Bei Caddy ist dieselbe Aufgabe in 3 bis 6 Zeilen erledigt, weil TLS, der Redirect und die üblichen Proxy-Header Teil des Normalverhaltens sind. Bei Traefik stehen rund 17 Zeilen statische Konfiguration für Entry-Points, Provider und ACME-Resolver, plus 5 Labels pro Dienst. Ein Fehler, den ich dabei regelmäßig sehe: Wer den statischen Teil vergisst, wundert sich, warum die Labels am Container nichts bewirken.
Das ist der Kern dieser Zahlen. nginx schreibt auf, was passiert. Caddy lässt weg, was offensichtlich ist. Traefik verteilt die Konfiguration auf zwei Orte, einmal statisch auf der Platte und einmal dynamisch am Container.
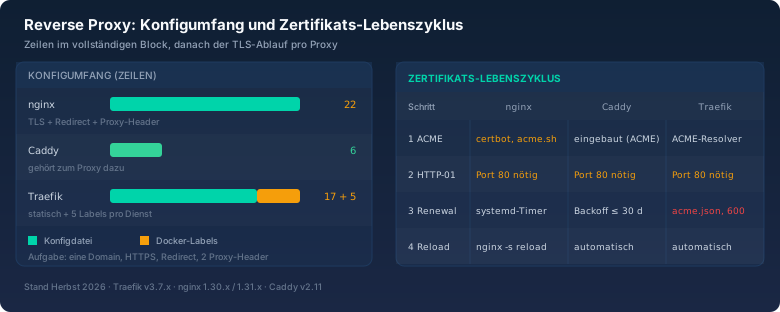
Die linke Hälfte der Grafik zeigt die Zeilen, die rechte den Zertifikats-Lebenszyklus in vier Schritten, jeweils aufgeschlüsselt danach, was der einzelne Proxy dafür tut. Der Lebenszyklus ist der aussagekräftigere Teil. Bei nginx stehen in der Spalte ein externes Werkzeug und ein systemd-Timer. Bei Caddy steht in der Spalte, dass die Anforderung, die Challenge und das Renewal zum eingebauten Verhalten gehören. Bei Traefik läuft es über einen ACME-Resolver, dessen Zustand in einer Datei liegt, die nur der Traefik-Benutzer lesen darf.
TLS und Zertifikate: hier trennt sich der Betriebsaufwand
Zertifikate sind der Punkt, an dem ein Proxy nicht mehr nach Konfigurationsgeschmack, sondern nach Betriebsaufwand bewertet wird. Ein Zertifikat ist 90 Tage gültig, es muss also erneuert werden. Immer. Auf jedem Host, in jedem Jahr.
Bei nginx läuft die Erneuerung nicht im Proxy, sondern in einem zweiten System. certbot oder acme.sh holen die Zertifikate, ein eigener systemd-Timer stößt das an, und der Proxy lädt die neuen Dateien erst nach einem Reload. Das funktioniert seit Jahren zuverlässig, es ist nur ein zusätzlicher beweglicher Teil, der überwacht werden muss. Wie das im Detail aussieht, habe ich in Let's Encrypt automatisieren aufgeschrieben, inklusive der Timer-Einheit und der Hooks für den Reload.
Caddy hat das in den Proxy eingebaut. ACME ist Standardverhalten, holt Zertifikate von Let's Encrypt, fällt bei Bedarf auf ZeroSSL zurück und erneuert mit exponentiellem Backoff, bis 30 Tage vor Ablauf ein erster Versuch startet. Wenn ich bei Caddy ein Zertifikat erneuern muss, tue ich das nicht, weil ich etwas nachpflege, sondern weil ich eine Fehlermeldung in einem Log sehe. Zwei Details gehören in die Betriebsanleitung: Der Zertifikatspfad liegt unter /var/lib/caddy/.local/share/caddy und gehört ins Backup, weil ein frisch installierter Caddy bei einem Restore sonst alle Zertifikate neu anfordert und Rate-Limits reißt. Und für rein interne Namen gibt es `tls internal`, das eine lokale CA verwendet, statt zu versuchen, eine öffentliche Domain zu validieren.
Traefik arbeitet mit einem ACME-Resolver, der pro Entry-Point definiert wird. Sein Zustand liegt in einer Datei namens acme.json. Und hier kommt die Falle, die mich das erste Mal eine halbe Stunde gekostet hat: acme.json muss für andere Benutzer unlesbar sein. Traefik prüft die Dateirechte und verweigert die Datei, wenn zu viele Leute hineinschauen könnten. Die Datei gehört mit Rechten 600 ins Backup, und die Fehlermeldung dazu liest sich erst einmal nicht wie ein Rechteproblem.
Bekannte Grenzen: Cache, mTLS, HTTP/3
Alle drei Proxies haben Grenzen, die man vorher kennen sollte, weil sie später Architektur entscheiden.
Beim HTTP-Response-Cache ist nginx klar vorn. proxy_cache ist ausgereift, gut dokumentiert und in den letzten zehn Jahren in tausend Setups bewährt. Traefik in der Open-Source-Variante bringt keinen Response-Cache mit, das ist ein Feature der kommerziellen Editionen. Caddy kann zwischenspeichern, aber nur über ein Plugin, das man selbst einbindet. Wer Antworten am Rand cachen will, ist mit nginx schneller fertig.
Bei Client-Zertifikaten, also mTLS, sind die anderen beiden dran. nginx löst das über ssl_client_certificate und ssl_verify_client, Caddy über einen eigenen client_auth-Block in der Site-Definition. Bei Traefik geht das nur über den File-Provider, also über eine statische Konfigurationsdatei statt über Labels, was in einer Umgebung, die komplett über Labels arbeitet, ein Bruch ist.
Bei HTTP/3 ist Caddy der einzige mit Standardverhalten, QUIC ist einfach an. Traefik unterstützt es, aber noch als experimentelles Feature. Bei nginx geht es nur über ein Drittmodul, das man selbst baut und pflegt. Wer heute HTTP/3 ohne Basteln will, landet bei Caddy.
Wann welcher Proxy
Bei dieser Frage werden Benchmark-Tabellen gern zu Ranglisten umgedeutet, obwohl sie keine sind. Die Entscheidung fällt nicht über den Durchsatzgewinner, sondern über zwei Dinge: Wo kommt die Konfiguration her, und wie viel Betriebsaufwand will ich tragen?
Wenn die Konfiguration aus einer Datei kommt und du sie im Git liegen hast, dann nimm nginx, wenn du Erfahrung damit hast und Cache oder exotische Rewrites brauchst. Wenn du eine Datei willst, aber den TLS-Teil nicht selbst bauen möchtest, nimm Caddy. Das ist der Proxy für Hosts, die du einmal aufsetzt und danach nicht mehr anfassen willst: Webserver, kleine API-Container auf einer VM, ein Reverse Proxy auf einer Synology oder einem Raspberry Pi. Wenige Zeilen, TLS von allein, Reload von allein.
Wenn die Konfiguration dagegen dynamisch ist, wenn Dienste kommen und gehen, wenn Container pro Deploy neu erzeugt werden und gerade der mit dem richtigen Label die Anfragen bekommen soll, dann nimm Traefik. Er ist der einzige, bei dem das Registrieren eines Dienstes heißt: Label setzen und Container starten. Der Preis ist der Speicherbedarf und die Tatsache, dass ein Tippfehler im Label sofort live ist.
Es gibt eine Kombination, die ich selbst häufig fahre: Traefik am Rand, weil dort die Dienste wechseln, und dahinter ein nginx pro Backend, der die Anwendung ausliefert. Man muss sich nicht für einen entscheiden, man muss entscheiden, wo welche Konfiguration herkommt. nginx als reine Datei-Verwaltung und Traefik als Label-Verwaltung lassen sich gut kombinieren, solange klar ist, wer bei welchem Hostname zuständig ist.
Zweiter Faktor ist der Betriebsaufwand, und der lässt sich in einer Frage zusammenfassen: Wer ändert die Konfiguration, wenn ein Dienst dazukommt? Wenn das ein Mensch ist, der sich auf einem Server einloggt, will er eine Datei mit klaren Zeilen und einen Reload-Befehl. Wenn das eine Pipeline ist, die einen Container startet, will sie keine Datei anfassen. Beide Wege sind richtig, sie schließen sich nur gegenseitig aus. Ein Setup, in dem die halbe Routing-Konfiguration in einer Datei und die andere Hälfte in Labels steht, ist genau die Konstruktion, die in einem halben Jahr niemand mehr vollständig überblickt.
Betriebsfallen, die ich alle schon getroffen habe
Die erste Falle ist die HTTP-01-Challenge. Bei diesem Verfahren prüft Let's Encrypt, ob auf Port 80 deines Hosts eine bestimmte Datei erreichbar ist. Das heißt: Port 80 muss aus dem Internet offen sein, auch wenn du selbst nur HTTPS nutzt. Ich hatte den Port einmal nach einer Firewall-Regel geschlossen, und die Fehlermeldung las sich wie ein DNS-Problem. Der Hostname löste nämlich korrekt auf, nur der Challenge-Request kam nicht an. Wenn die Zertifikatserneuerung plötzlich fehlschlägt, ist die erste Frage nicht "stimmt der DNS?", sondern "ist Port 80 noch offen?".
Die zweite Falle ist die Startreihenfolge. Der Proxy muss oben sein, bevor die Backends bereit sind, sonst startet er mit einer Fehlerkonfiguration oder liefert 502er aus, bis die Anwendungen hochgekommen sind. Bei Systemd-Setups heißt das: der Proxy-Dienst startet früh und die Anwendung später, und der Proxy muss einen Backend-Ausfall als vorübergehend behandeln, nicht als Konfigurationsfehler in seinem Log verarbeiten.
Die dritte Falle sind die Timeouts. WebSockets brauchen lange Timeouts, große Uploads brauchen lange Timeouts, lang laufende Queries brauchen lange Timeouts. Die Standardwerte sind alle zu kurz für diese Fälle. Die Verbindung bricht dann nicht sofort ab, sondern nach zwei Minuten, mitten in einem Upload oder einem Datenbank-Dump. Und weil es der Proxy ist, der die Verbindung schließt, sieht die Anwendung davon nichts.
Die vierte Falle ist Traefik-spezifisch: Labels wirken sofort. Es gibt keinen Deploy-Schritt und keine Validierung, die einen Tippfehler im Routen-Begriff abfängt. Ein Label, das einen Service an eine falsche Domain bindet, ist in dem Moment live, in dem der Container startet. Ich habe mir so schon eine Staging-Domain auf das Produktions-Backend gebunden, ohne dass irgendwo eine Warnung auftauchte.
Die fünfte Falle ist eher eine Erleichterung, aber man muss sie kennen: Caddy setzt X-Forwarded-For und X-Forwarded-Proto selbst und ignoriert dabei, was ein Client in diesen Headern mitschickt. Das ist genau richtig so, es verhindert, dass jemand über einen gefälschten Header Zugriffslogik austrickst. Nur: Ein eigener Header mit demselben Namen, den man irgendwo definiert, wird nicht angehängt, sondern ersetzt. Wer dahinter Logik auf den Header baut, sollte wissen, welcher Proxy ihn schreibt.
Versionen im Herbst 2026
Für die Einordnung, mit welchen Ständen ich hier arbeite: Traefik ist bei v3.7.x, nginx läuft in der Stable-Linie bei 1.30.x und in der Mainline bei 1.31.x, Caddy steht bei v2.11. Alle drei Kandidaten werden aktiv gepflegt, es geht bei keiner Variante um ein Projekt, das man 2026 noch neu aufsetzen sollte, weil es jemand weiterentwickelt oder nicht. Die Frage ist nicht Zukunftssicherheit, sondern Passung.
Bei nginx lohnt der Blick auf die Linie: Stable bekommt Sicherheits- und Bugfixes, Mainline bekommt neue Features und wird trotz des Namens für den Produktivbetrieb empfohlen. Wer neue Module braucht, ist mit der Mainline schneller. Bei den Docker-Images ist die Versionswahl der zweite Punkt, an dem ich in Setups Fehler finde: ein Tag wie latest holt beim nächsten Deploy eine andere Version, und ein Proxy, der sich beim Neustart verändert hat, ist die unangenehmste Art von Überraschung. Ich pinne die Version im Compose-File und aktualisiere sie bewusst.
Fingerprints vergleichen mit dem Hash-Generator
Ein Punkt, der bei Zertifikaten unterschätzt wird, ist die Kontrolle der Kette selbst. Wenn du wissen willst, ob dein Proxy wirklich das Zertifikat ausliefert, das deine interne CA signiert hat, vergleichst du nicht das Zertifikat, sondern seinen Fingerprint. Auf der Kommandozeile geht das mit openssl x509 -fingerprint -sha256, das dir den SHA-256-Hash der Zertifikatskette ausgibt. Wenn du diesen Hash mit dem vergleichst, den deine CA oder dein Monitoring dokumentiert hat, weißt du in fünf Sekunden, ob jemand ein anderes Zertifikat eingeschoben hat oder ob der Proxy noch auf einem alten Pfad steht.
Für die Formatierung solcher Hashes nutze ich den Hash-Generator. Er nimmt Text oder Dateiinhalte und gibt den SHA-256-Wert aus, den man direkt gegen den Fingerprint aus openssl und gegen die Dokumentation der CA legen kann. Klingt nach einem Detail, ist aber die schnellste Prüfung, die ich kenne, wenn ein Zertifikatsproblem nicht nach einem Konfigurationsfehler aussieht.
Fazit: die Zugriffsschicht entscheiden, nicht gewinnen wollen
Nach all den Zahlen bleibt eine einfache Aufteilung, mit der ich seit Jahren fahre. nginx, wenn die Konfiguration in einer Datei liegt, Erfahrung vorhanden ist und du Cache oder mTLS brauchst. Caddy, wenn du eine Datei willst und TLS, Redirect und Header nicht in Handarbeit schreiben möchtest. Traefik, wenn die Konfiguration aus Container-Labels kommen soll und Dienste häufiger wechseln als die Konfigurationsdatei.
Wer die Entscheidung über den Benchmark-Winner treffen will, trifft sie über die falsche Achse. Die 15 Prozent Durchsatzunterschied zwischen nginx und Caddy sind an keinem realen Tag in meinem Betrieb messbar geworden. Der Tag, an dem ein Zertifikat abgelaufen ist, weil der Timer tot war, war dagegen sofort messbar, und zwar auf der Kundenwebsite.
Wenn du also in diesem Monat einen Reverse Proxy aufsetzt, würde ich drei Dinge vorher festhalten: Wer erneuert das Zertifikat, wo liegt die Konfiguration, und wann hat zuletzt jemand nachgesehen, ob Port 80 noch offen ist. Wer diese drei Fragen beantworten kann, hat die schwierigen Teile gelöst, lange bevor die erste Anfrage über den Proxy läuft.
Als Nebenlektüre passt hier aus dem Blog noch strukturierte Logs mit journald dazu, weil der Proxy genau der Punkt ist, an dem alles ankommt, was später im Log landen soll, und weil ein Proxy, der sauber journald bedient, die Fehlersuche nach einem Ausfall erheblich verkürzt.