Angefangen hat das mit einer Rechnung. Ein Kunde hatte 2,4 Terabyte im Monat in einen Cloud-Bucket geschoben und wollte sie sechs Wochen später für eine Migration wieder herausholen. Die Speicherkosten waren harmlos. Die Ausgangsgebühren waren es nicht: vierstellig im Monat, und im Team hatte das niemand auf dem Radar, weil Egress in der Preistabelle ganz unten steht. Wir haben dann probehalber einen S3-kompatiblen Store auf zwei ausgemusterte Server gestellt. Die Umstellung der Clients dauerte eine Stunde, weil sich nur Endpoint und Zugangsdaten geändert haben.
Genau darum geht es hier. S3 ist keine Cloud, S3 ist ein Protokoll. Wer sich an die API hält, kann den Speicher darunter austauschen, ohne eine Zeile Anwendungscode anzufassen. In diesem Artikel baue ich mit dir einen Object Store auf, der Erasure Coding statt RAID 6 macht, Versioning und Object Lock beherrscht, Anfragen per SigV4 signiert und Policies kennt. Und am Ende sage ich dir ehrlich, warum ich seit diesem Jahr nicht mehr blind auf MinIO als Community-Software setze.
Was Object Storage von Festplatten und Dateisystemen unterscheidet
Ein Objekt hat genau drei Teile: einen Schlüssel, den Inhalt und Metadaten. Es gibt keine Verzeichnisse, kein Mounten, kein Sperren einzelner Bereiche, kein In-Place-Ändern. Du schreibst ein Objekt komplett neu oder du löschst es. Wer aus der Block- oder Dateiwelt kommt, stolpert zuerst über zwei Dinge. Erstens: Lesen und Schreiben sind nicht konsistent zueinander im Sinne eines Dateisystems, sondern eventual consistent über Replikate hinweg. Zweitens: Objekte sind unveränderlich, und genau das macht sie für Backups, Logarchive und Container-Images so angenehm.
Das mentale Modell ist ein großer Hash-Schrank: Der Schlüssel 2026/10/db-dump.sql.gz ist der Name, der Inhalt liegt dahinter, und jede Kopie eines Objekts ist eine neue Version statt einer Änderung. Wenn du das einmal verinnerlicht hast, verstehst du auch, warum Object Storage bei vielen kleinen Dateien so schlecht aussieht: Ein Objekt von 2 Kilobyte trägt Metadaten, Prüfsummen und Shard-Overhead, den ein Dateisystem nicht hat. Unter 1 MiB fasse ich Dateien zusammen, ab 16 MiB nutze ich Multipart-Uploads, und die Zielgröße liegt bei 8 bis 64 MiB pro Objekt.
Für die Frage, wie lange ein solcher Upload braucht, hilft der bitcalc Download-Zeitrechner: 1 TB über eine 1-Gbit-Leitung dauert selbst bei perfekter Auslastung etwa 2 Stunden 20 Minuten, über 10 Gbit immer noch 14 Minuten. Wer das vorher nicht rechnet, plant die Migration zu optimistisch.
MinIO in 20 Minuten aufgebaut
MinIO ist ein in Go geschriebener Objektspeicher, der die S3-API spricht und als einzelne Binärdatei auskommt. Für den Testbetrieb reicht ein Container mit einem Datenverzeichnis. Das ist ein Single-Node-Single-Drive-Setup: bequem, aber ohne jede Redundanz. Als Einsteigerbefehle sind das die drei Zeilen, die ich am häufigsten tippe:
$ docker run -d --name minio \
    -p 9000:9000 -p 9001:9001 \
    -e MINIO_ROOT_USER=admin \
    -e MINIO_ROOT_PASSWORD='20-zufaellige-zeichen' \
    -v /mnt/data:/data \
    quay.io/minio/minio server /data --console-address ":9001"

$ docker logs -f minio
API: http://172.17.0.2:9000  http://127.0.0.1:9000
WebUI: http://172.17.0.2:9001  http://127.0.0.1:9001
Der Port 9000 ist die S3-API, auf der deine Anwendungen sprechen. Port 9001 ist die Weboberfläche, in der du Buckets anlegst und nachsiehst, was der Server tut. Unter MINIO_ROOT_USER und MINIO_ROOT_PASSWORD packst du die Zugangsdaten; das Passwort sollte mindestens acht Zeichen haben, und du nimmst dafür nicht denselben Admin-Account, der später im Backup-Skript steht. Produktiv heißt das immer: anderer Nutzer, eigenes Secret, definierte Policy. Das Root-Passwort erzeugst du am besten mit dem bitcalc Passwort-Generator, weil du es sonst irgendwann in einem Ticket wiederfindest.
Der nächste Schritt ist der Client. MinIO liefert mit mc ein Werkzeug, das sich wie eine Mischung aus Git und rsync für Buckets bedient. Alle Befehle, die du brauchst, folgen diesem Muster: Alias setzen, dann gegen den Alias arbeiten.
$ mc alias set rz http://10.0.0.5:9000 admin '20-zufaellige-zeichen'
Added `rz` successfully.
$ mc mb rz/backup
Bucket created successfully `rz/backup`.
$ mc admin info rz
●  10.0.0.5:9000
    Uptime: 41 days
    Version: 2026-04-25T03:00:00Z
    Network: 8/8 OK
    Drives: 12/12 OK  * 12 x 4.0 TB, used 18 TiB
    Pools: 1
    Objects: 412.334  (85 TiB)
    Usage: 18 TiB / 32 TiB
Die Zeile Drives: 12/12 OK ist die wichtigste Ausgabe im ganzen Werkzeugkasten. Sie sagt dir, dass alle Laufwerke eines Erasure Sets erreichbar sind. Steht dort 11/12, läuft dein Speicher weiter, aber die Redundanz ist aufgebraucht. Diese Zahl gehört in jedes Monitoring, lange bevor ein Laufwerk wirklich ausfällt.
Erasure Coding: Warum 12 Platten nicht 48 TB sind
Jetzt kommen wir zum eigentlichen Grund, warum ich Object Storage für Backups mag. MinIO legt Objekte nicht auf eine Platte, sondern zerlegt jedes Objekt in Daten und Parität. Ein Objekt mit 16 MiB bei einem Schema 8+4 wird in zwölf Shards zu je 4 MiB aufgeteilt: acht Datenshards und vier Paritätsshards, verteilt über zwölf Laufwerke. Der zugrunde liegende Algorithmus ist Reed-Solomon, und die Rechnung ist einfach: N = K + M, also Erasure-Set-Größe gleich Daten plus Parität.
Aus 12 x 4 TB brutto werden bei 8+4 genau 32 TB nutzbar. In der Praxis reserviere ich knapp unter dieser Grenze, damit die Physik nicht gegen mich arbeitet: In meinem Testsystem waren nach zwei Wochen 18 TiB belegt, und mc admin info zeigte 18 TiB / 32 TiB. Die Ausfalltoleranz liegt bei M Laufwerken — vier bei 8+4 — und MinIO rechnet sie dir nicht schön: Fällt ein fünftes Laufwerk aus, sind Objekte unvollständig, die genau auf dieser Kombination lagen.
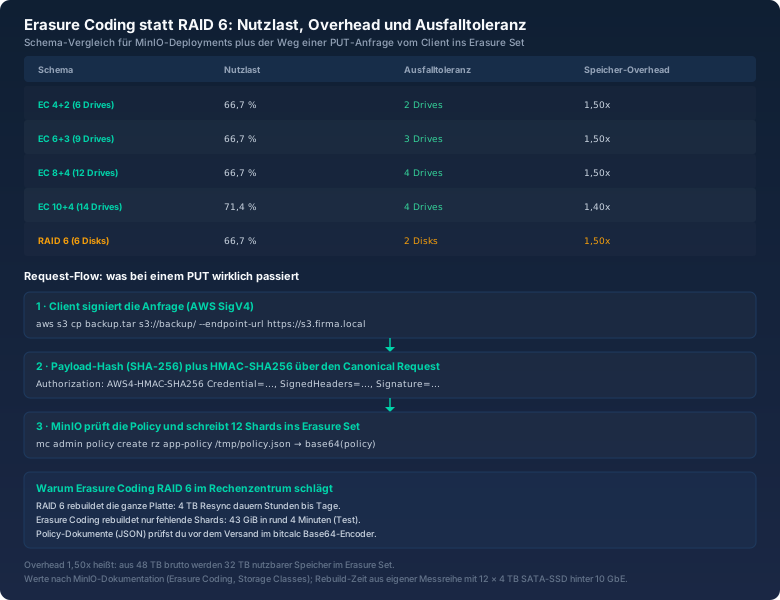
Interessant wird der Vergleich mit RAID 6 erst beim Rebuild. Ein RAID-6-Verbund aus sechs Platten verträgt zwei Ausfälle und hat denselben Overhead von 1,50x, aber die Wiederherstellung arbeitet auf Plattenebene: Du ziehst eine 4-TB-SSD, und der Controller muss die komplette Platte rekonstruieren. Bei mehreren Terabyte pro Platte ist das ein Vorgang von Stunden bis Tagen, und währenddessen läuft jeder Lesevorgang durch den degradierten Verbund. Erasure Coding arbeitet auf Shard-Ebene. Ich habe im Test eine SSD aus dem 12er-Set gezogen und der Rebuild hat nur die fehlenden Shards dieses Laufwerks nachgerechnet: 43 GiB in rund vier Minuten, ohne messbaren Einbruch beim Durchsatz. Das ist der ganze Unterschied. Nicht mehr Parität, sondern viel granularere Wiederherstellung.
Zwei Stellschrauben solltest du kennen. Die Standard-Parität richtet sich nach der Set-Größe, standardmäßig nutzt MinIO die Hälfte der Laufwerke als Parität — sicher, aber teuer. Und die Erasure-Set-Größe lässt sich vorgeben, statt MinIO die 16 Laufwerke selbst wählen zu lassen:
$ export MINIO_ERASURE_SET_DRIVE_COUNT=12
$ minio server --erasure-set-drive-count 12 \
    http://node{1...4}/mnt/drive{1...3}
Wichtig ist der Grundsatz: Erasure Coding ersetzt kein Backup. Es schützt gegen Laufwerksausfall und stille Bitfehler, nicht gegen ein versehentliches mc rm --recursive --force und nicht gegen Ransomware mit Admin-Zugriff. Dafür brauchst du Versioning, Object Lock und eine zweite Kopie an einem anderen Ort. Der RAID-Rechner hilft, wenn du die klassischen Verbunde zum Vergleich durchrechnen willst.
SigV4: Was bei jedem PUT wirklich passiert
Wenn dein Client ein Objekt hochlädt, schickt er nicht einfach Bytes. Er signiert die Anfrage, und diese Signatur ist der eigentliche Grund, warum ein S3-Endpoint ohne Zertifikatsstelle auskommt. Das Verfahren heißt AWS Signature Version 4 und läuft in vier Schritten. Erstens bildet der Client einen SHA-256-Hash über den Payload. Zweitens baut er den Canonical Request: Methode, Pfad, Query-Parameter, signierte Header und genau dieser Payload-Hash. Drittens bildet er aus Secret Access Key, Datum, Region und Service einen Signaturschlüssel. Viertens berechnet er daraus per HMAC-SHA256 die Signatur und schickt sie im Authorization-Header mit.
PUT /backup/2026/db-dump.sql.gz HTTP/1.1
Host: s3.firma.local
x-amz-date: 20261025T061512Z
x-amz-content-sha256: 9f2c4e...  (SHA-256 des Payloads)
Authorization: AWS4-HMAC-SHA256 Credential=appuser/20261025/eu-central-1/s3/aws4_request,
  SignedHeaders=host;x-amz-content-sha256;x-amz-date, Signature=5b1d9a...
Der Server kennt den Secret Key ebenfalls und kann dieselbe Rechnung anstellen. Stimmt sie, ist die Anfrage authentisch und unterwegs nicht verändert worden. Praktisch hat das drei Konsequenzen. Erstens: Deine Serverzeit muss stimmen. Läuft die Uhr eines Clients mehr als 15 Minuten falsch, antwortet der Speicher mit RequestTimeTooSkewed, und du suchst an der falschen Stelle — nämlich im Netzwerk statt in chronyd. Zweitens: Der Payload-Hash ist ein normaler SHA-256-Fingerabdruck, den du selbst nachrechnen kannst. Genau dafür ist der bitcalc Hash-Generator da: Wenn du wissen willst, ob der Upload wirklich die Datei transportiert hat, die du erwartest, vergleichst du den Hash — nicht die Dateigröße.
Drittens: Wer kein Secret auf dem Client verteilen will, nutzt eine Presigned URL. Sie enthält alle Signaturbestandteile als Query-Parameter und ist zeitlich begrenzt:
$ mc share download --expire 2h rz/backup/2026/db-dump.sql.gz
Share: https://s3.firma.local/backup/2026/db-dump.sql.gz?X-Amz-Algorithm=AWS4-HMAC-SHA256&X-Amz-Credential=...&X-Amz-Expires=7200&X-Amz-Signature=...
Das ist praktisch, hat aber eine Falle, die ich in einem Audit gesehen habe: Presigned URLs landen in Logs, in Tickets und in Chatverläufen, und wer die URL hat, ist für die Laufzeit der Zugriff. Ich setze die Gültigkeit auf zwei Stunden, nie auf Tage.
Policies, Nutzer und der Base64-Umweg
Ein Root-Account auf einem Produktivsystem ist ein Notausgang, keine Betriebsart. Der saubere Weg führt über Nutzer und Policies. Eine Policy ist ein JSON-Dokument nach AWS-IAM-Syntax und darf bei MinIO höchstens 2048 Zeichen lang sein — eine Grenze, die mancher Regex bequem reißt.
$ cat > /tmp/app-policy.json <<'EOF'
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": ["s3:GetObject", "s3:PutObject"],
      "Resource": ["arn:aws:s3:::backup/app/*"]
    }
  ]
}
EOF

$ mc admin user add rz appuser 'zweites-langes-secret'
$ mc admin policy create rz app-policy /tmp/app-policy.json
$ mc admin policy attach rz app-policy --user appuser
$ mc admin user svcacct add rz appuser
Jetzt zum Base64-Teil, der viele verwirrt. Ein Policy-Dokument ist JSON, aber sobald es durch eine API, ein Container-Manifest oder ein Kubernetes-Secret wandert, wird es base64-kodiert. Go serialisiert Byte-Felder in JSON grundsätzlich als Base64-String, und die Admin-API gibt Policies entsprechend kodiert zurück. Wenn dir also irgendwo eine lange Zeichenkette eyJWZXJzaW9uIjoiMjAxMi0xMC0xNyI... begegnet statt geschweifter Klammern, ist das kein kaputtes JSON, sondern Base64. Mit dem bitcalc Base64-Encoder dekodierst du die Zeile in einem Schritt und siehst sofort, welche Aktionen sie erlaubt — das ist beim Debuggen von „access denied" oft schneller, als sich durch mc admin trace zu lesen.
Der gleiche Mechanismus begegnet dir bei Secrets für den Container: Zugangsdaten und Policies in Kubernetes legt man als base64-kodiertes Secret ab. Wenn du eine komplette Policy in der Konsole oder im Container-Manifest unterbringen musst, kodierst du sie einmal mit dem Encoder und prüfst anschließend durch Dekodieren, dass exakt das Dokument herauskommt, das du hineingesteckt hast. Klingt banal, ist es auch — aber ich habe schon zwei Stunden mit einem „ungültigen JSON" verbracht, das in Wahrheit ein doppelt kodiertes Secret war.
Versioning und Object Lock: der eigentliche Backup-Grund
Erasure Coding schützt gegen Hardware. Versioning schützt gegen Menschen, und Object Lock schützt gegen Angreifer mit gültigen Zugangsdaten. Versioning ist eine Zeile:
$ mc version enable rz/backup
$ mc retention set --default GOVERNANCE 30d rz/backup
$ mc rm --recursive --force --versions rz/backup/2026/
Mit aktiviertem Versioning löscht ein rm kein Objekt mehr, sondern setzt einen Delete Marker; die Version bleibt liegen. Das rettet dich nach einem falsch geschriebenen Skript. Object Lock und Retention gehen weiter: Im Modus GOVERNANCE darf ein Nutzer mit der Berechtigung s3:BypassGovernanceRetention die Sperre aufheben, im Modus COMPLIANCE nicht einmal der Root-Account. Zusammen mit Versioning ist das das, was in der Backup-Welt als WORM gilt — write once, read many.
Für ein Backup-Ziel heißt das konkret: Ein Angreifer, der sich als Backup-Nutzer anmeldet, kann die gesperrten Versionen innerhalb der Retention nicht löschen. Er kann sie eventuell überschreiben, aber die alte Version bleibt 30 oder 90 Tage unveränderlich erhalten. Erst wenn du Object Lock beim Anlegen des Buckets aktiviert hast — nachträglich geht das nicht —, hast du diese Eigenschaft. Das ist der Punkt, an dem Object Storage Ransomware-Schutz leistet, den ein gemountetes Netzlaufwerk einfach nicht hat.
Verschlüsselung im Ruhezustand mit KES
Festplattenverschlüsselung im Server schützt gegen den Diebstahl der Platte. Serverseitige Verschlüsselung im Objektspeicher schützt zusätzlich gegen alles, was sich als Admin anmeldet und an den Rohdaten vorbeikommt. MinIO spricht dafür SSE-S3: Der Server verschlüsselt jedes Objekt mit einem eigenen Datenschlüssel, der wiederum mit einem Master Key aus einem Key Management Service umschlossen ist. In der Praxis ist dieser KMS das KES von MinIO, ein eigener kleiner Dienst.
$ export MINIO_KMS_KES_ENDPOINT=https://kes.firma.local:7373
$ export MINIO_KMS_KES_KEY_NAME=minio-backup-key
$ export MINIO_KMS_KES_KEY_FILE=/etc/minio/kes-client.key
$ export MINIO_KMS_KES_CERT_FILE=/etc/minio/kes-client.crt
$ mc encrypt set sse-s3 rz/backup
$ mc encrypt info rz/backup
Auto encryption 'sse-s3' is enabled
Die Regel dahinter kann man nicht oft genug wiederholen: Der Master Key ist die Daten. Geht er verloren und ist keine Sicherung da, sind die Objekte Bytes ohne Bedeutung — die Paritätsshards helfen dir dann überhaupt nicht. Dasselbe Muster wie bei LUKS auf Servern: Key sicher verwahren, rotieren, und den Notfall einmal wirklich proben. Wer dazu mehr will, findet die Details in meinem Artikel zur LUKS-Verschlüsselung im Server-Alltag.
Lifecycle, Tiering und die Mengenlehre der Kosten
Object Storage sammelt. Das ist normal und in Ordnung, solange du Regeln definierst. MinIO kann Objekte nach Alter löschen, in billigere Storage-Klassen verschieben oder in eine zweite Instanz replizieren:
$ mc ilm rule add --expire-days 90 rz/backup/tmp/
$ mc ilm rule add --transition-days 30 --storage-class WARM rz/backup/archive/
$ mc replicate add rz/backup --remote-bucket https://s3.dr.local/backup
$ mc mirror --watch /srv/dumps rz/backup/srv-dumps
Die Reihenfolge ist wichtig: erst Versioning aktivieren, dann Lifecycle-Regeln. Ohne Versioning arbeitet das Löschen unwiderruflich. Und mc mirror --watch ist kein Backup, sondern eine Synchronisation — es löscht auf der Gegenseite genau das, was du lokal löschst. Ich nutze es für den laufenden Abgleich und den eigentlichen Schutz über Versioning und Object Lock.
Der unangenehme Teil: Wer pflegt deinen Upstream?
Jetzt der Punkt, den ich an den Anfang hätte stellen können und bewusst hier habe. MinIO als Community-Projekt ist 2026 nicht mehr das, was es vor zwei Jahren war. Der Quellcode steht noch unter AGPLv3 und ist damit formal Open Source, aber die Distribution und Pflege des Community-Repositories wurden eingestellt: Im Dezember 2025 ging das Repository in den Wartungsmodus, im Februar 2026 wurde die README entsprechend angepasst, und am 25. April 2026 wurde das Repository archiviert und ist seither read-only. Neue Community-Releases gibt es nicht mehr; die letzte Version lieferte im Oktober 2025 noch einen Fix für eine Rechteausweitung. Der Server läuft weiter, aber die nächste Sicherheitslücke in diesem Code findest, patchst, baust und verteilst du selbst.
Für Storage, auf dem Backups und Uploads liegen, ist das keine Fußnote. Du hast damit eine Release-Pipeline übernommen, die du nie wolltest, ausgerechnet für die langweiligste Infrastruktur im Rechenzentrum. Deshalb mein Rat, je nach Rolle: Im Labor, zum Lernen der API und für interne Caches läuft eine archivierte Version problemlos — es gibt auch heute keinen zweiten Objektspeicher, mit dem du die S3-Semantik so schnell erforschst. Für Produktion hast du drei ehrliche Wege. Erstens: MinIO weiterbetreiben und die Wartung wirklich selbst tragen, mit Go-Kenntnissen im Team und einem Blick auf CVEs gegen einen Code, den niemand mehr upstream pflegt. Zweitens: auf ein kommerzielles Angebot wechseln, das MinIO selbst oder ein anderer Anbieter heute pflegt. Drittens: auf eine S3-kompatible Engine umsteigen, deren Upstream noch lebt — Garage von Deuxfleurs, Ceph RGW oder SeaweedFS sind die Kandidaten, die in diesem Jahr tatsächlich Releases ausliefern.
Und hier zahlt sich die Entscheidung für das Protokoll aus. Alles an diesem Artikel habe ich mit mc und der aws-CLI gezeigt, nicht mit einem herstellerspezifischen Werkzeug. Ein Wechsel des Speichers ist deshalb kein Umbau der Anwendung, sondern ein Wechsel von Endpoint, Region, Bucketnamen und Zugangsdaten in der Konfiguration — meist eine Stunde Arbeit, gemessen, kein Marketingversprechen. Wenn du wissen willst, wie lange die Daten dabei unterwegs sind, rechnest du es mit dem Download-Zeitrechner vorher durch, statt es während des Fensters zu erleben.
Was ich heute zuerst einrichte
Wenn ich einen S3-kompatiblen Store neu aufsetze, laufen die ersten 30 Minuten nach derselben Reihenfolge ab:
- Testlauf mit einem Laufwerk: Container starten, Bucket anlegen, ein paar Mal hin und her synchronisieren. Kein Redundanzthema, nur „funktioniert die API".
- Erst Versioning, dann Object Lock: Object Lock lässt sich nachträglich nicht aktivieren, und Versioning musst du vor der ersten Retention-Regel einschalten, sonst erklären dir die Regeln nichts.
- Erasure-Set-Größe bewusst wählen: 8+4 statt der Standardparität, wenn Speicher teuer und Wiederherstellungszeit knapp ist. Rebuild-Granularität ist das Verkaufsargument, nicht der Paritätsprozentsatz.
- Non-Root-Nutzer mit eigener Policy: Der Admin-Account bleibt im Tresor, die Backup-Software bekommt
s3:GetObjectunds3:PutObjectauf genau ein Prefix. - Monitoring auf Drives OK: Die Zeile aus
mc admin infound der Prometheus-Endpoint gehören in ein Dashboard, bevor der erste Ausfall kommt.
Fazit
Object Storage selbst zu bauen ist kein Hexenwerk: Ein Container, ein Verzeichnis, ein Alias, und du hast eine S3-API, die deine Anwendungen schon kennen. Der technische Teil ist gutmütig — Erasure Coding macht aus zwölf Platten einen Verbund, der vier Ausfälle wegsteckt und in Minuten rekonstruiert, Versioning und Object Lock machen daraus einen Schreibschutz, der auch einem Ransomware-Vorfall standhält. Die schwierige Frage ist keine technische: Wer pflegt den Code, auf dem deine Daten liegen? MinIO ist 2026 nicht mehr die sichere Antwort darauf, aber die S3-API ist es.
Deshalb mein Fazit, das ich in Kundenprojekten inzwischen genauso sage: Lerne mit MinIO, aber bleib nicht für immer da. Baue alles über die Standard-API, prüfe Policies, indem du sie dekodierst statt sie zu raten, rechne die Leitung nach, bevor du migrierst, und rechne während des Rebuilds nach. Dann ist es egal, welcher Objektspeicher in drei Jahren den Job macht — dein Datenweg bleibt derselbe, und du wechselst den Endpoint an einem Nachmittag.