Es war 23:40 an einem Dienstag, und die Datenbank eines Kunden schrieb keine Daten mehr. Kein Absturz, keine Fehlermeldung im Monitoring, nur ein Postgres-Log voller „No space left on device". Die Wurzel lag nicht in der Datenbank, sondern in der Partitionierung: /var/lib/postgresql lag auf einem eigenen Logical Volume, das jemand zwei Jahre vorher mit exakt 200 GB angelegt hatte. Wachstum war damals nicht vorgesehen, heute fehlten 12 GB.
Der klassische Weg hätte bedeutet: Wartungsfenster beantragen, Dienst stoppen, Volume sichern, neu partitionieren, zurückspielen — vier bis sechs Stunden. Der tatsächliche Weg war eine Minute Arbeit: Eine zusätzliche Platte war im Gehäuse noch frei, also pvcreate, vgextend, lvextend -r -L +100G und weiter. Die Datenbank lief durch, der Kunde merkte nichts, ich war um 23:50 wieder im Bett. Genau für diesen Moment existiert LVM. Und genau deshalb hat es sich in jedem meiner Server gehalten, obwohl moderne Dateisysteme wie ZFS und Btrfs mehr können.
Der zweite Teil dieser Geschichte ist weniger schön, und er erklärt, warum dieser Artikel auch von Fallen handelt. Ein Kollege hatte dieselbe Idee, aber mit XFS und in die andere Richtung: Er wollte ein zu groß geratenes Volume verkleinern und setzte lvreduce mit der Annahme an, das Dateisystem folge schon. Es folgte nicht. XFS kennt kein Schrumpfen. Er verlor den Zugriff auf 400 GB, das Volume war logisch kleiner als die Datenmenge darin. Der Restore dauerte zwei Tage, weil er die richtige Snapshot-Kette suchte. LVM belohnt, wer die Reihenfolge kennt, und bestraft, wer rät.
Drei Schichten, drei Werkzeuge
LVM schiebt zwischen Festplatte und Dateisystem eine Zwischenschicht, den Device Mapper. Aus drei Bausteinen wird ein Stapel:
- Physical Volume (PV): eine Platte oder Partition, die LVM gehören darf. Anlegen mit
pvcreate. LVM legt einen Metadatenkopf an, vorhandene Dateisysteme werden dabei überschrieben. - Volume Group (VG): ein Pool aus einem oder mehreren PVs. Anlegen mit
vgcreate. Die VG ist die Ebene, die wächst und schrumpft. - Logical Volume (LV): das Stück, das ein Dateisystem trägt. Anlegen mit
lvcreate. Das LV ist das, was du in/etc/fstabeinträgst.
Die Rechnung dahinter ist unspektakulär, aber sie erklärt alle Grenzen: Eine VG kann nur so viel Volumen vergeben, wie ihre PVs an Platz hergeben. Ist die VG voll, hilft nur eine weitere Platte — Größe versprechen kann ein LV nur innerhalb dieses Pools. Deshalb liegt der eigentliche Trick nicht im Erweitern, sondern im Pool. Wer eine VG aus drei Platten baut statt aus einer, kann später einen Fünfjährigen Ausbau ohne Umbau überstehen.
Die kleinste Einheit ist der Extent. Voreingestellt sind 4 MiB. Ein lvcreate -L 500G rundet also auf ein Vielfaches von 4 MiB, und wer mit -l arbeitet (kleines L), zählt in Extents statt in Gigabyte. In der Praxis ist das die häufigste Fehlerquelle beim Rechnen von Hand: 500 GB sind 128.000 Extents, nicht 500 irgendwas.
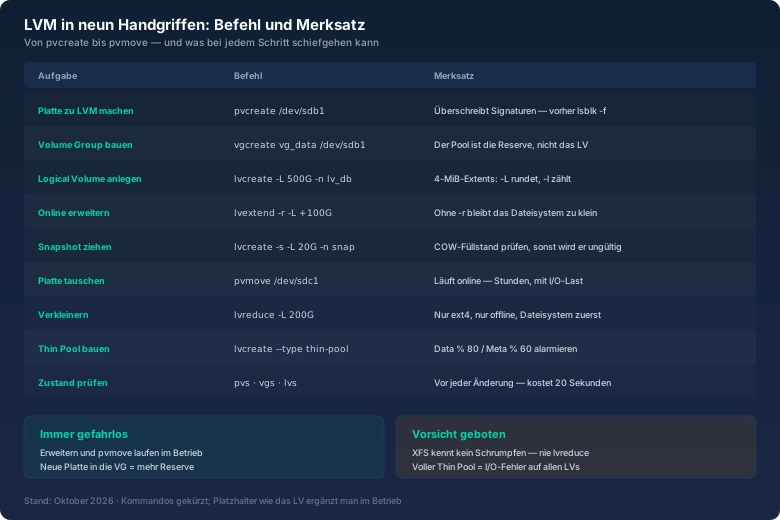
Vor jeder Änderung lohnt der Blick auf den Zustand. Drei Kommandos liefern alles, was man braucht, wenn man ihre Spalten liest:
# pvs
  PV         VG      Fmt  Attr PSize   PFree
  /dev/sdb1  vg_data lvm2 a--   <3,64t  <1,64t
  /dev/sdc1  vg_data lvm2 a--   <1,82t   1,82t
# vgs
  VG      #PV #LV #SN Attr   VSize  VFree
  vg_data   2   3   0 wz--n-  5,46t  3,46t
# lvs -o +data_percent,metadata_percent
  LV      VG      Attr       LSize   Data%  Meta%
  lv_root vg_data -wi-ao---- 100,00g
  lv_var  vg_data -wi-ao---- 200,00g
  lv_db   vg_data -wi-ao---- 200,00g
  pool    vg_data twi-aotz-- 1,00t   41,20  12,60
PFree in der PV-Ausgabe und VFree in der VG-Ausgabe sind der Vorrat, aus dem ein neues LV oder ein Wachstum bezahlt wird. Die beiden letzten Prozentwerte betreffen nur Thin Pools und sind der wichtigste Frühindikator im ganzen Setup. Wer sie nicht im Monitoring hat, merkt einen volllaufenden Pool erst, wenn Anwendungen I/O-Fehler werfen.
Der Klassiker: erweitern im laufenden Betrieb
Platte rein, Partition drauf (parted oder sfdisk, Typ 8e für LVM), dann drei Kommandos. Wichtig: pvcreate überschreibt Dateisystem-Signaturen auf der Zielplatte. Bei einer gebrauchten Platte ist das gewollt, bei der falschen Platte ist es der teuerste Tippfehler des Jahres. Ich prüfe vorher immer mit lsblk -f und wipefs -n, was auf dem Gerät liegt.
# pvcreate /dev/sdd1
  Physical volume "/dev/sdd1" successfully created.
# vgextend vg_data /dev/sdd1
  Volume group "vg_data" successfully extended
# lvextend -r -L +100G /dev/vg_data/lv_db
  Size of logical volume vg_data/lv_db changed from 200,00 GiB to 300,00 GiB.
  Logical volume vg_data/lv_db successfully resized.
  resize2fs 1.47.0: /dev/mapper/vg_data-lv_db auf 78643200 (4k) Blöcke
  Das Dateisystem auf /dev/mapper/vg_data-lv_db ist nun 78643200 Blöcke groß.
Das -r ist der Teil, den man einmal vergisst und nie wieder: Es lässt LVM das Dateisystem gleich mitwachsen. Ohne -r ist das LV größer, das Dateisystem darin aber unverändert — der Platz existiert, ist aber unbenutzbar. Wer die Schritte lieber getrennt sieht, macht es klassisch: lvextend -L +100G /dev/vg_data/lv_db, dann resize2fs für ext4 oder xfs_growfs /mnt/db für XFS. Letzteres nimmt den Mountpunkt, nicht das Gerät — ein Detail, das bei Skripten regelmäßig schiefgeht.
Zwei Zahlen aus meiner Praxis: Auf einer Maschine mit 40 GB freiem VG-Vorrat dauerte das Erweitern um 100 GB weniger als zwei Sekunden, weil nur Metadaten geschrieben wurden. Das anschließende resize2fs beschäftigt sich lediglich mit den neu hinzugekommenen Blöcken. Deshalb ist Erweitern auch auf einem produktiven Datenbankserver unkritisch, während Schrumpfen nie ein Live-Vorgang ist.
Snapshots: kurze Fenster, keine Backups
Ein LVM-Snapshot ist eine Kopie auf dem Papier. Beim Anlegen entsteht ein neues LV, das auf denselben Daten steht wie das Original. Erst wenn sich ein Block im Original ändert, wird der alte Block in den Snapshot kopiert — Copy on Write. Der Snapshot braucht also nicht die Größe des Originals, sondern die Größe der Änderungen, die während seiner Lebensdauer auflaufen.
# lvcreate -s -L 20G -n snap_db /dev/vg_data/lv_db
  Logical volume "snap_db" created.
Genau hier sitzt die häufigste Fehleinschätzung. „20 Prozent vom Original" ist keine Regel, sondern ein Vorurteil. Die relevante Frage lautet: Wie viel schreibt die Anwendung in dem Zeitraum, in dem der Snapshot leben soll? Für einen konsistenten Backup-Lauf über 40 Minuten bei 8 MB/s Schreiblast sind das rund 19 GB — dann ist 20 GB richtig dimensioniert und 40 GB wäre Verschwendung. Für einen Snapshot, der eine Woche als Rollback-Punkt für ein Upgrade dient, ist dieselbe Rechnung völlig anders, und dann gehört der Snapshot wahrscheinlich nicht auf dasselbe Volume.
Läuft der zugewiesene Platz voll, passiert das Unangenehme: LVM markiert den Snapshot als ungültig und entfernt ihn. Der Snapshot ist dann nicht „halb kaputt", er ist weg. Im lvs-Output steht das als Status: INVALID, und zwar ohne Vorwarnung, wenn niemand den COW-Füllstand überwacht. Deshalb gehört ein Blick auf lvs -o name,origin,data_percent in jedes Backup-Skript — nicht in das Monitoring der Anwendung, sondern direkt in das Skript, das den Snapshot benutzt.
Was Snapshots können: eine konsistente Sicherung ziehen, ohne die Anwendung zu stoppen; einen Testlauf gegen den Datenstand von gestern fahren; ein Paket-Upgrade mit Rückrollpfad starten. Was sie nicht können: eine ausgefallene Platte überleben. Der Snapshot liegt auf derselben VG, also auf denselben physischen Platten. Ein Plattenausfall nimmt Original und Snapshot mit. Deshalb bleibt der Satz aus meinem Backup-Artikel unverändert gültig: Ein Snapshot ist ein Zeitfenster, kein Backup.
Thin Pools: elegant, aber mit Verfallsdatum
Thin Provisioning dreht die Logik um: Ein Thin Pool wird einmal mit physischem Platz angelegt, und die daraus erzeugten LVs dürfen zusammen mehr versprechen, als der Pool hat. Ein 1-TB-Pool kann fünf LVs mit je 400 GB tragen, solange in Summe weniger als 1 TB tatsächlich beschrieben ist.
# lvcreate --type thin-pool -L 1T -n pool vg_data
# lvcreate -V 400G --thinpool pool -n lv_www
# lvcreate -V 400G --thinpool pool -n lv_mail
Der Vorteil ist Bequemlichkeit: Volumes bekommen großzügige Größen, ohne dass Platten danach reserviert sind. Der Preis ist eine Krisenquelle eigener Art. Ist der Pool voll, bekommen nicht die Anwendungen mit dem größten Verbrauch Probleme, sondern alle — der dünne Datenbereich liegt unter jedem LV des Pools, und alle LVs treffen gleichzeitig auf Schreibfehler statt auf eine saubere „Disk full"-Meldung. Aus einer Speicherfrage wird damit ein Anwendungsausfall.
Deshalb gilt für Thin Pools eine Regel, die ich seit einem Vorfall nicht mehr verlasse: Der Schwellenwert für Data% liegt bei 80, der für Meta% bei 60, und beide Werte hängen an einem Alarm. Meta% wird regelmäßig vergessen, weil niemand mit einem vollen Metadatenbereich rechnet — er ist klein (typisch 1 bis 4 GB) und wächst durch viele kleine Snapshots und Thin-Volumes. Eine VG mit 3.000 Snapshots kann an Metadaten ersticken, während Datenplatz reichlich frei ist. Und: lvextend hilft beim Thin Pool nur, wenn die VG noch freie Extents hat — deshalb nie den letzten freien Platz im Pool verplanen.
Verkleinern: ext4 ja, XFS nein
Das ist die Falle aus der Einleitung, und sie hat nichts mit Mut zu tun, sondern mit Physik des Dateisystems. XFS wächst im Betrieb und kann nicht schrumpfen — nicht mit LVM, nicht mit xfs_repair, nicht mit Werkzeugen Dritter. Wer XFS kleinere Grenzen geben will, sichert, legt neu an, spielt zurück. Punkt.
ext4 kann schrumpfen, aber nur offline und in dieser Reihenfolge: erst das Dateisystem verkleinern, dann das LV. Umgekehrt stehen die Daten außerhalb ihres eigenen Containers und sind verloren.
# umount /mnt/db
# e2fsck -f /dev/mapper/vg_data-lv_db
# resize2fs /dev/mapper/vg_data-lv_db 200G
# lvreduce -L 200G /dev/mapper/vg_data-lv_db
# mount /mnt/db
Wer sich die exakte Größenrechnung sparen will, gibt bei resize2fs eine Zielgröße an, die kleiner ist als das LV, und lässt dann lvextend -r das LV auf die tatsächliche Dateisystemgröße ziehen. Das ist unspektakulär, spart aber die Rechnerei in Blöcken.
Platten tauschen ohne Wartungsfenster
Ein Physical Volume zu ersetzen, während die VG in Betrieb ist, ist der eleganteste Teil von LVM. pvmove verschiebt die Extents auf die verbleibenden bzw. bereits ergänzten PVs — online, mit laufenden Anwendungen.
# pvmove /dev/sdc1
  /dev/sdc1: Moved: 8,4% ... 100,0%
# vgreduce vg_data /dev/sdc1
# pvremove /dev/sdc1
Realität: Die Geschwindigkeit liegt bei einer 2-TB-Platte und ~120 MB/s Kopierleistung bei knapp vier Stunden. In dieser Zeit ist I/O-Last auf der VG, und die Überwachung sollte auf Antwortzeiten achten, nicht auf Durchsatz. Zwei Bedingungen müssen vorher erfüllt sein: Ziel-PVs mit genügend freien Extents im selben VG, und keine Snapshots mit gefüllten COW-Bereichen, die pvmove zusätzlich mitziehen muss. Bei Servern mit drei Stunden Wartungsfenster pro Jahr ist das trotzdem mein Lieblingswerkzeug: Ersatzplatte einbauen, pvmove laufen lassen, dabei Kaffee trinken, danach die alte Platte ziehen.
Wann LVM die falsche Antwort ist
Ich mag LVM, aber es ist kein Ersatz für ein Dateisystem mit Prüfsummen. LVM verteilt Blöcke, es kennt keine Datenintegrität, keine Prüfsummen pro Block, kein Selbstheilen. Wer Bitrot fürchten muss und Redundanz will, ist bei ZFS besser aufgehoben — dort sind Snapshots unveränderlich, Prüfsummen allgegenwärtig und Plattenpools verstehen Redundanz. Btrfs bietet einen Teil davon auf Dateisystemebene, mit anderem Reifegrad.
Die Aufgabenteilung, mit der ich gut fahre: LVM für das Layout und die Flexibilität, ein klassisches Dateisystem für die Daten, eine Prüfsummenschicht nur dort, wo Redundanz wirklich zählt. Läuft darauf zusätzlich Verschlüsselung, sitzt LUKS unter dem Dateisystem und über der Platte — die Reihenfolge von LVM und LUKS entscheidet, ob du Snapshots verschlüsseln kannst oder nicht, dazu steht das Nötige im LUKS-Artikel.
Und dann ist da noch die Größenrechnung, die erfahrungsgemäß alle in die Irre führt: Plattenhersteller liefern Terabyte, das Dateisystem erwartet Tebibyte. Eine „10-TB-Platte" hat 9,1 TiB, und nach LVM-Metadaten und Extent-Rundung bleiben davon je nach Pool-Konfiguration rund 9,0 TiB übrig. Wer Kapazitäten plant, sollte diese Zahl einmal sauber umrechnen — dafür gibt es den Kapazitäts-Umrechner, der dezimal und binär nebeneinander stellt.
Fünf Regeln aus fünf Jahren LVM im Betrieb
- Pool vor Volumen planen: Eine VG mit mehreren PVs ist die Versicherung, die man später nicht mehr kaufen kann. Lieber eine Platte mehr im Verbund als ein einzelnes LV an der Grenze.
- Erweitern im Betrieb, verkleinern nur offline: Ext4 schrumpft im Wartungsfenster, XFS gar nicht. Wer einem Live-System eine kleinere Grenze geben will, sichert und spielt zurück.
- Snapshots nur als Fenster, nie als Ersatz: Dimensionieren auf erwartete Änderungen, im Skript den COW-Füllstand prüfen, nach jedem Backup wieder abräumen.
- Thin Pools überwachen:
Data%ab 80 alarmieren,Meta%ab 60. Ein voller Pool ist ein Ausfall aller LVs, nicht eine Speichermeldung. - Vor jeder Änderung messen:
pvs,vgs,lvsundlsblk -fin zwanzig Sekunden. Fast jeder LVM-Unfall beginnt mit einem Kommando auf dem falschen Gerät.
Fazit
LVM ist kein Spektakel, sondern ein Layout-Werkzeug: drei Schichten, ein Extent-Raster und ein paar Kommandos, die man einmal lernt. Sein Wert zeigt sich nicht beim Aufsetzen, sondern zwei Jahre später, wenn ein Volume ohne Wartungsfenster wachsen muss und niemand den Dienst stoppen darf. Der Preis dafür ist Verantwortung: Wer Snapshots für Backups hält, Thin Pools ohne Alarm betreibt oder auf XFS herumschrumpft, holt sich genau die Ausfälle, die das System verhindern sollte.
Der Datenbankserver von damals läuft übrigens noch, inzwischen auf einer VG mit drei Platten und mit 400 GB Reserve. Das Volume ist seitdem zweimal gewachsen — beide Male an einem Dienstagabend, ohne dass jemand außer mir davon erfahren hat. So soll Admin-Arbeit aussehen.