Der Anruf kam an einem Freitag um 16:20: Ein neu installierter ESXi-Host sah die SAN-LUNs nicht, und die Storage-Kollegen waren schon im Wochenende. Der Host hatte zwei HBAs, beide LEDs grün, die Switches zeigten die Ports als online, das Array zeigte die Controller als gesund. Der Fehler saß eine Ebene höher: die Zonen waren angelegt, aber der Zone Set war nie aktiviert worden. cfgshow zeigte die Konfiguration, cfgactvshow zeigte nichts — und ein Fabric ohne aktive Zone setzt keine Zonen durch.
Was mich an dieser Nacht beschäftigt hat, war nicht der Fehler, sondern die Reihenfolge der Diagnose. Alle fünf Beteiligten hatten auf ihrer Ebene recht. Fibre Channel ist keine schwarze Magie, aber es ist eine Kette mit fünf Gliedern, und die Kette reißt am schwächsten — nicht am auffälligsten. Wer die Reihenfolge kennt (HBA, Optik, Fabric, Zoning, LUN-Mapping) und jedes Glied einzeln prüft, braucht für diese Klasse von Störungen zwanzig Minuten statt eines Wochenendes.
Dieser Artikel ist für Admins, die ein SAN aufbauen oder erben. Er erklärt die Begriffe, die auf dem Zettel stehen, zeigt die Kommandos, mit denen man jede Ebene prüft, und benennt die Fehler, die erfahrungsgemäß am meisten Zeit kosten — inklusive der Frage, wann Fibre Channel die richtige Antwort ist und wann iSCSI oder NVMe over Fabrics die günstigere.
Was Fibre Channel ist — und was es nicht ist
Fibre Channel ist ein eigenes Netzprotokoll für Block-Storage, das auf Glasfaser (oder kurzen Kupferstrecken) läuft. Es ist nicht TCP/IP mit einem anderen Stecker: FC ist für eine Aufgabe gebaut — SCSI-Kommandos verlustfrei, in Reihenfolge und mit garantierter Bandbreite zu übertragen. Deshalb gibt es kein Routing im IP-Sinn, keine Fragmentierung und keine Neuwahlen im Fluss, sondern eine Fabric, in der jedes Gerät über eine eindeutige Kennung ansprechbar ist.
Das entscheidende Merkmal gegenüber Ethernet-basierten Verfahren: FC ist flussgesteuert (Buffer-to-Buffer-Credits) und kann keine Pakete wegen Überlast verwerfen. Wenn du Bandbreite gekauft hast, bekommst du sie — bei iSCSI teilst du dir dieselbe Ethernet-Strecke mit allem anderen. Genau dieser Punkt und nicht die Geschwindigkeit ist es, der Fibre Channel bis heute in Virtualisierungs- und Datenbankumgebungen hält.
Die Kehrseite ist der Preis und die Kompetenzverteilung: HBAs, Switches, Optiken und SAS-ähnliche Lizenzen kosten ein Vielfaches eines 10-GbE-Switches, und wer sich mit FC auskennt, ist im Team meist eine Person. Wer Storage für ein Homelab oder einen kleinen Kunden baut, fährt mit iSCSI über zwei getrennte Switches fast immer besser. Wer zwei ESXi-Hosts an ein Enterprise-Array hängt und dafür einen Wartungsvertrag braucht, ist bei FC richtig.
Die vier Ebenen, auf denen ein SAN entsteht
Ein SAN-Pfad besteht aus vier Bausteinen, die in dieser Reihenfolge entstehen und in dieser Reihenfolge geprüft werden: HBA, Optik und Kabel, Fabric, LUN-Zuordnung. Der fünfte Baustein ist die Redundanz darüber — Multipath — und sie ist der Grund, warum man in einem ordentlichen SAN zwei von allem hat.
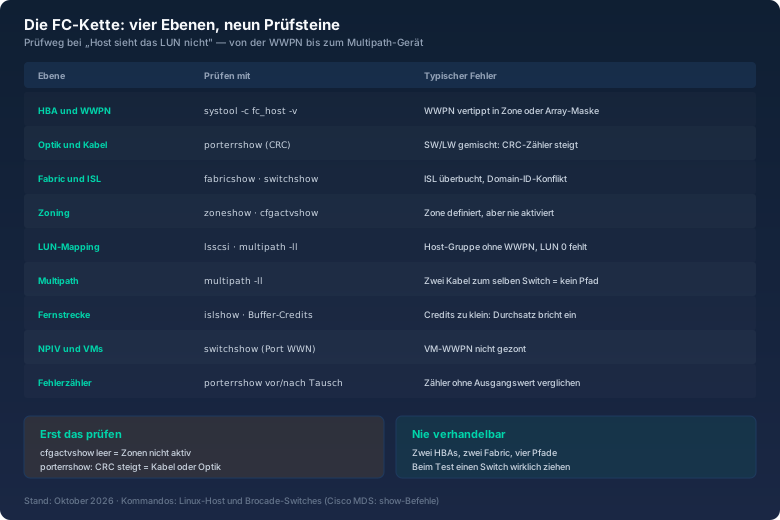
Der HBA ist die Karte im Host. Sie hat pro Port eine weltweit eindeutige Kennung, die WWPN (World Wide Port Name), ein 64-Bit-Wert, den man im Switch und im Array einträgt. Anzeigen lässt er sich ohne Werkzeug im laufenden Betrieb:
# systool -c fc_host -v | grep -E 'Class Device|port_name|port_state|speed'
  Class Device = "host8"
    port_name   = "0x10000000c9a1b2c3"
    port_state  = "Online"
    speed       = "32 Gbit"
# cat /sys/class/fc_host/host8/port_name
0x10000000c9a1b2c3
Die WWPN ist der Schlüssel für alles Weitere: sie steht in den Zonen, in der LUN-Maske im Array und in der Multipath-Tabelle. Ein einzelnes falsch abgetipptes Hex-Paar in einer Zone ist die Ursache Nummer eins für „Host sieht das LUN nicht", und man erkennt es nicht an den LEDs, sondern nur am Abgleich der Zeichenketten. Ich schreibe die WWPNs deshalb in eine Inventardatei, bevor der erste Switch konfiguriert wird — nicht in ein Ticket, nicht in ein Wiki, sondern in eine Datei, die beim Aufbau offen ist.
Optik und Kabel: die stille Fehlerquelle
Fibre Channel läuft auf Multimode (OM3/OM4, orange/türkis, kurze Strecken) oder Singlemode (OS2, gelb, Weitverkehr). Entscheidend ist, dass Optik, Patchkabel und Switch-Port zusammenpassen: eine Singlemode-Optik auf einem Multimode-Kabel leuchtet nicht schlechter aus — sie funktioniert gar nicht oder wirft Fehler. Die Klassifizierung steht auf dem SFP: SW für Short Wave (Multimode), LW für Long Wave (Singlemode).
Die Fehler, die daraus entstehen, sind unsichtbar, weil die Verbindung im Link-Status trotzdem „online" meldet. Sie zeigen sich erst in den Fehlerzählern der Switch-Ports, und genau dort muss man nachsehen, wenn ein Host sporadische Pfadverluste hat:
# porterrshow
  frames  enc out  disc  link  loss  loss   frjt  fbsy  crc  crc  crc
             err     c3   fail  sync   sig                g_eof
  1.2g     0   0     0     0     0      0      0      0    0    0    0
  1.4g   18m   0     0     4     0      4      0      0  142    0  142
Die Zeile des Ports 1.4 zeigt vier Link-Failures und 142 CRC-Fehler. CRC-Fehler bedeuten: die Frames kommen an, aber ihre Prüfsumme stimmt nicht. Ursache sind fast immer Kabel, Stecker, Optik oder ein verschmutzter Ferrule — nicht der Host, nicht das Array, nicht die Software. Ich tausche in dieser Reihenfolge: Patchkabel, Optik, Portseite, und prüfe nach jedem Tausch, ob der Zähler stehen bleibt. Wichtig: Die Zähler sind kumulativ. Ohne Notiz des Ausgangswerts nach dem Tausch kann man nicht sagen, ob es besser wurde. Deshalb: porterrshow vor dem Tausch, kurz protokollieren, danach erneut.
Fabric, Port-Typen und was Zoning wirklich macht
Sobald ein Switch im Spiel ist, heißt das Netz „Fabric". Der Switch vergibt intern ein Domain-ID und baut aus den angeschlossenen Ports eine Vermittlungsschicht. Die Port-Typen, deren Namen einem im Log um die Ohren fliegen, sind schnell erklärt:
- N_Port — der Port am Endgerät, also am HBA oder am Array-Controller.
- F_Port — der Port am Switch, an dem ein N_Port hängt.
- E_Port — die Verbindung zwischen zwei Switches (Inter-Switch Link, ISL). Aus einzelnen Switches wird damit eine Fabric.
- G_Port — ein Port, der noch nicht weiß, was er wird. Die Anzeige wechselt beim Login automatisch zu F oder E.
- NPIV — N_Port ID Virtualization: ein physischer Port meldet mehrere virtuelle WWPNs an. So bekommt jede VM mit Raw Device Mapping ihre eigene WWPN, und das Zoning kann auf VM-Ebene greifen.
Zoning ist die Zugangskontrolle der Fabric: Es legt fest, welche Ports sich überhaupt sehen dürfen. Ohne Zonen gibt es die Default-Zone, in der jedes Gerät jedes andere sieht — bequem beim Aufbau, gefährlich im Betrieb, denn ein falsch konfigurierter Host kann dann fremde LUNs sehen und im schlimmsten Fall beschreiben. Der Unterschied zwischen den beiden Zonenvarianten ist wichtig:
- Soft Zoning — der Name Server versteckt die nicht erlaubten Geräte vor der Abfrage. Der Datenverkehr wird nicht hardwareseitig blockiert; ein Host, der die Ziel-WWPN kennt, könnte sie theoretisch direkt ansprechen.
- Hard Zoning — der Switch-ASIC filtert Frames. Moderne Switches erzwingen das für WWPN-Zonen automatisch. In Kombination mit namensbasierten Zonen ist Hard Zoning die Variante, die man haben will.
Was ich in der Praxis konfiguriere: namensbasierte Zonen (WWPN), eine Zone pro Initiator-Target-Paar (Single Initiator, Single Target — SIST), Aliasnamen aus Hostname und Array-Port, und so wenige Zonen wie möglich. Die Regel „eine große Zone für alles" spart zwanzig Minuten beim Aufbau und kostet bei jeder Störung Stunden, weil dann alle Hosts gemeinsam im RSCN-Sturm hängen, wenn ein Gerät flattert. Ein RSCN ist die Fabric-Nachricht „die Mitgliederliste hat sich geändert"; bei einer großen Zone reagieren alle darauf.
Und die Pointe vom Anfang: Ein Zone Set wird nach dem Ändern nicht automatisch aktiv. Zwei Kommandos, die man kennen muss:
# cfgshow | head -6            # definierte Konfiguration
# cfgactvshow                  # -> leer: nichts ist aktiv
# cfgadd san_prod zone_esx01_arrA0
# cfgactv san_prod             # <- dieser Schritt setzt die Zonen durch
# cfgactvshow                  # -> Zone Set: san_prod (aktiv)
LUN-Masking: die zweite Hürde nach dem Zoning
Eine korrekte Zone ist die halbe Miete. Die andere Hälfte liegt im Array: Ein LUN muss einem Initiator oder einer Host-Gruppe zugeordnet werden, üblicherweise über die WWPN. Erst dann darf der Host das Gerät sehen. Deshalb ist die Reihenfolge beim Aufbau nicht beliebig: Erst müssen die WWPNs aller HBA-Ports bekannt sein, dann werden sie im Array als Host mit zwei HBA-Ports angelegt, dann wird der Host-Gruppe das LUN zugewiesen, und erst danach bringt ein Rescan das Gerät im Betriebssystem.
Scheitert es hier, ist das Symptom typisch: Der Port ist online, die Zone ist aktiv, im Betriebssystem taucht aber kein LUN auf. Prüfen lässt sich das von der Hostseite aus:
# systool -c fc_remote_ports -v | grep -E 'port_name|roles'
# lsscsi -w | grep -i 'fc\|san'
# multipath -ll | head -20
Zwei Klassiker, die dazugehören: Manche Arrays präsentieren das erste LUN nur auf LUN 0, und ein Host, dem LUN 0 nicht gemappt ist, sieht nichts — das erste Mapping gehört deshalb auf LUN 0. Und: Nach einem Array-seitigen Mapping ist kein Reboot nötig, ein Rescan reicht. Der richtige Rescan ist kein Neustart des Stacks, sondern ein gezielter Scan der SCSI-Hosts.
Multipath: zwei von allem, und zwar wirklich zwei
Redundanz im SAN bedeutet nicht „zwei Kabel zum selben Switch". Sie bedeutet zwei HBAs, zwei Fabric (A und B), zwei Controller im Array — und daraus vier Pfade pro LUN. Erst dann überlebt der Betrieb den Ausfall eines HBAs, eines Switches oder eines Storage-Controllers. Der Host darf die vier Pfade nicht als vier Platten sehen, sondern muss sie über Multipath zu einem Gerät bündeln.
Im Schema sieht das so aus — drei ESXi-Hosts, zwei getrennte Fabric, ein FC-angebundenes Array:
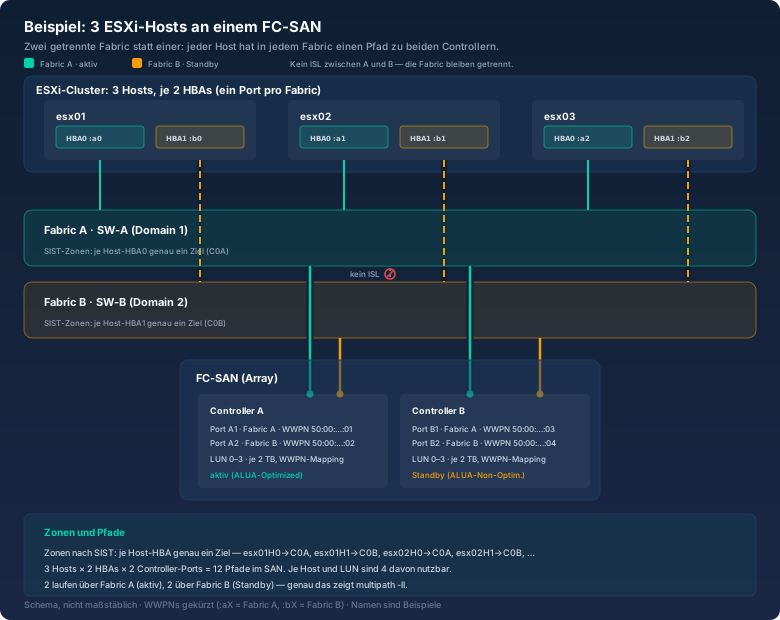
Zähl die Leitungen im Bild nach: Von jedem Host führen zwei ab (eine je Fabric), jede Fabric erreicht beide Controller — das ergibt vier Pfade je Host und LUN und zwölf im ganzen SAN. Der Punkt, der den Aufbau von einem billigen SAN unterscheidet, steht zwischen den beiden Fabric: das rote Zeichen. Zwischen A und B gibt es bewusst keine Verbindung. Nur so kann ein Fehler in einem Fabric — ein flatternder Port, ein RSCN-Sturm, ein Konfigurationsfehler — nicht auf das zweite durchschlagen.
# multipath -ll
mpatha (3600009700001968015535330303035) dm-3 WDC,IntelliFlash
size=2.0T features='1 queue_if_no_path' hwhandler='1 alua' wp=rw
|-+- policy='service-time 0' prio=50 status=active
| |- 8:0:0:1 sdb 8:16  active ready running
| `- 9:0:0:1 sdc 8:32  active ready running
`-+- policy='service-time 0' prio=10 status=enabled
  |- 10:0:0:1 sdd 8:48  active ready running
  `- 11:0:0:1 sde 8:64  active ready running
Vier Pfade, zwei aktiv über Fabric A, zwei im Standby über Fabric B. So sieht ein gesundes SAN aus. Der Test, den ich bei jeder Übergabe einmal fahre: einen der beiden Fabric-Switches für die Dauer von zehn Minuten aus dem Verkehr ziehen und beobachten, ob Anwendungen und Monitoring ruhig bleiben. Wer diesen Test scheut, weil er „prod" ist, hat keine Redundanz, sondern die Hoffnung darauf.
Ein Detail, das regelmäßig Zeit kostet: Nach einem Array-Update oder einem Switch-Neustart kann ein Controller-Failover alle Pfade einer Fabric auf einen Schlag umschalten. Das sieht im Monitoring wie ein Ausfall aus — ist aber ein ALUA-Zustandswechsel. Wer die Pfade nicht als zwei Gruppen liest, sondern als vier gleichwertige, sucht an der falschen Stelle. Deshalb steht in meinen Runbooks nicht „Pfadprüfung", sondern „Pfade je Fabric prüfen, aktiv/Standby-Zustand notieren".
Fernstrecke, Buffer-Credits und Oversubscription
Zwei Themen, die den Unterschied zwischen Labor und Rechenzentrum ausmachen. Erstens: FC ist flussgesteuert, und die Flusskontrolle arbeitet mit Buffer-Credits — die Anzahl der Frames, die gleichzeitig unterwegs sein dürfen. Ein Credit entspricht einem Frame, und ein Frame entspricht grob zwei Kilobyte Nutzdaten. Auf kurzen Strecken sind die Credits der Ports groß genug, dass niemand darüber nachdenkt. Auf Fernstrecken zwischen Rechenzentren werden sie zur Begrenzung: Die Herstellerregel lautet grob, dass pro Kilometer Entfernung zusätzliche Credits nötig sind — je höher die Portgeschwindigkeit, desto mehr. Wer eine Fern-ISL plant, braucht diese Rechnung vorab, nicht danach.
Zweitens: Oversubscription. Ein 48-Port-Switch mit vier ISLs an einen Rack-Switch bedeutet Subscription Ratio 11:1. Das ist für Virtualisierung mit Burst-Charakter sehr oft in Ordnung — Storage-Last ist selten parallel auf allen Ports. Für eine Datenbank mit sechs Knoten im Synchron-Modus oder für Storage-vMotion mehrerer VMs gleichzeitig ist es nicht in Ordnung. Die ehrliche Antwort: Das Verhältnis allein sagt nichts, entscheidend ist die Peak-Parallelität deiner Anwendung. Wenn du sie nicht kennst, miss sie, bevor du kaufst.
Wann Fibre Channel die falsche Antwort ist
Der Satz sei erlaubt, weil er Zeit und Geld spart: Ein SAN mit zwei Switches, zwei HBAs und Wartungsverträgen kostet in der Anschaffung das Fünffache einer iSCSI-Lösung mit zwei 10-GbE-Switches. Für Aufbauten, in denen Block-Storage über zwei dedizierte Ethernet-Switches läuft und niemand extremes IOPS-Profil braucht, ist iSCSI mit Multipath, Jumbo Frames und getrennten VLANs technisch gleichwertig — solange man die gleiche Disziplin (zwei von allem, getrennte Netze) anwendet.
Fibre Channel bleibt die bessere Wahl, wenn Latenzen und Jitter deterministisch sein müssen (Datenbanken mit harten Antwortzeit-Zusagen), wenn die Fabric ohnehin aus dem Enterprise-Array kommt, oder wenn NVMe over Fibre Channel im Spiel ist: FC-NVMe überträgt NVMe-Kommandos direkt über die bestehende Fabric und spart den SCSI-Übersetzungsweg. Wer 2026 neu baut und maximalen Durchsatz bei minimaler CPU-Last will, findet dort einen echten Vorteil — mit derselben Zonen- und Multipath-Disziplin wie oben.
Historisch gewachsen, aber noch in Betrieb: FCoE, Fibre Channel über Ethernet. Es hat sich im Markt nicht durchgesetzt, weil es die Komplexität beider Welten vereint — FC-Konfiguration plus Ethernet-Fabric mit DCB und Priority Flow Control. Wer es erbt, sollte wissen, dass es funktioniert, aber eine kleine Fangemeinde mit Spezialwissen hat.
Mein Aufbau in Kurzform
- Inventar zuerst: WWPN jedes HBA-Ports, Switch-Port-Zuordnung, Array-Controller-Ports, LUN-Nummern — als Datei, bevor der erste Befehl läuft.
- Zonen: SIST und benannt. Eine Zone pro Initiator-Target-Paar, Aliasnamen mit Hostname und Port, immer „Zone Set aktivieren" als eigenen Schritt prüfen (
cfgactvshow). - Fehlerzähler im Blick:
porterrshowvor und nach jedem Kabeltausch, CRC-Zähler als Hauptindikator für Optik- und Steckerprobleme. - Zwei von allem, dann testen: zwei HBAs, zwei Fabric, vier Pfade — und einmal pro Übergabe einen Switch aus dem Verkehr ziehen, um es zu beweisen.
- Fernstrecke vorher rechnen: Buffer-Credits und Subscription Ratio gehören in die Planung, nicht in die Nachbetrachtung.
Fazit
Fibre Channel ist eine Kette aus fünf Gliedern: HBA, Optik, Fabric, Zoning, LUN-Mapping — plus Multipath als Versicherung darüber. Jede Störung, die ich in zwölf Jahren SAN-Betrieb gesehen habe, ließ sich auf genau eines dieser Glieder zurückführen, und die längste Fehlersuche entstand nicht durch fehlendes Wissen, sondern durch fehlende Reihenfolge. Wer mit der WWPN anfängt, die Fehlerzähler liest, bevor er tauscht, und die Zonen erst dann für fertig erklärt, wenn cfgactvshow sie zeigt, braucht für die ganze Klasse keine Nacht mehr einzuplanen.
Der ESXi-Host von damals hat übrigens um 17:05 seine LUNs gesehen, eine Stunde vor dem Wochenende — mit einem cfgactv, das die Storage-Kollegen am Montag als „haben wir doch gesagt" quittierten. Auch das ist Admin-Alltag.