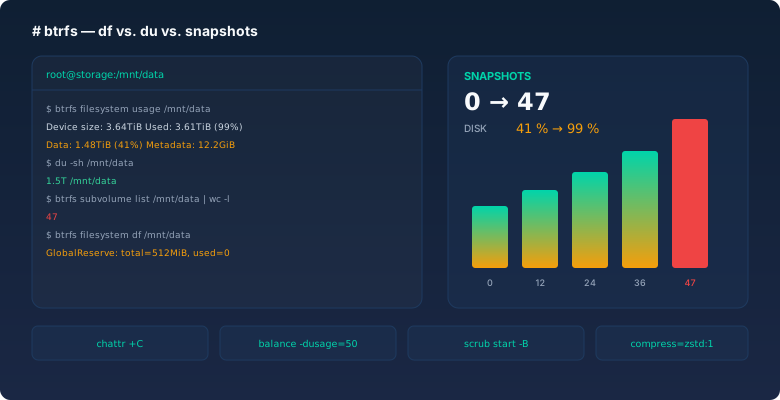
Der Anruf kam an einem Freitagnachmittag, kurz vor Feierabend. Ein Backup-Server meldete kein freies Volumen mehr, df stand bei 100 Prozent, und die Nachtjobs wären alle ins Leere gelaufen. Ich habe mich eingeloggt, du -sh über das Datenverzeichnis laufen lassen und 1,5 TB gezählt. Auf einem Dateisystem mit 3,6 TB nutzbarer Kapazität. Zwei völlig verschiedene Zahlen für dieselbe Sache, und keine davon war falsch.
Die Erklärung war btrfs. Auf dem Server liefen seit Monaten stündliche Snapshots, ausgelöst von einem Skript, das jemand eingerichtet und dann vergessen hatte. Jeder Snapshot hielt die alten Blöcke am Leben, die seither niemand mehr brauchte. Als ich die Liste abzählte, waren es 47. Der Speicher war nicht von meinen Daten gefressen worden, sondern von deren Geschichte. Seitdem habe ich eine Regel: Wer btrfs betreibt, ohne die drei Kommandos btrfs filesystem df, compsize und btrfs subvolume list auswendig zu kennen, betreibt es blind.
Dieser Artikel ist das, was ich in zwei Jahren btrfs auf Backup- und Virtualisierungsservern gelernt habe. Mit Zahlen aus eigenen Messungen, nicht mit Feature-Listen.
Wo btrfs heute steht
Vor acht Jahren habe ich btrfs gemieden, und das war damals die richtige Entscheidung. Der balance-Bug, der Pools volllaufen ließ, die RAID-5/6-Geschichte mit dem Write Hole, die fehlenden Werkzeuge zur Defragmentierung: Es gab genug Gründe, auf ZFS oder ext4 auszuweichen. Heute ist das anders. Der Kernel-Zweig 6.x hat einen stabilen Stand erreicht, btrfs ist bei openSUSE und SUSE Enterprise der Standard, bei Fedora die Vorgabe für die Workstation, und Synology baut seine NAS-Snapshots darauf. Das ist keine Nischensoftware mehr.
Was btrfs interessant macht, sind drei Eigenschaften, die zusammen einen echten Unterschied ergeben. Es arbeitet mit Copy-on-Write, es liefert Prüfsummen für Daten und Metadaten, und es kennt Subvolumes als eigenständige, adressierbare Einheiten. Alles andere — Snapshots, Kompression, RAID, Send/Receive — fällt aus diesen drei Eigenschaften heraus. Wer das einmal verstanden hat, kann sehr viel vorhersagen, ohne ein Handbuch zu öffnen.
Was btrfs nicht ist: ein Ersatz für ein Backup. Das klingt banal, aber es ist der Fehler, den ich am häufigsten sehe.
Subvolumes: Verzeichnisse, die man einzeln behandeln kann
Ein Subvolume ist kein Verzeichnis, auch wenn es in der Shell wie eines aussieht. Es ist ein eigener Teilbaum mit eigener Inode-Nummer und eigener Wurzel, den du einzeln snappen, einzeln senden und einzeln mounten kannst. Genau darauf beruht der ganze Rest.
Mein Standardlayout sieht so aus, und es hat sich bei etwa jedem System bewährt, das ich aufgesetzt habe:
# btrfs subvolume create /mnt/data/@
# btrfs subvolume create /mnt/data/@log
# btrfs subvolume create /mnt/data/@vm
# btrfs subvolume create /mnt/data/@snapshots
# btrfs subvolume list /mnt/data
ID 256 gen 18422 top level 5 path @
ID 257 gen 18419 top level 5 path @log
ID 258 gen 18417 top level 5 path @vm
ID 260 gen 18405 top level 5 path @snapshots
Der Punkt ist nicht Ordnung, sondern Trennung. Alles, was ich mitsichern will, liegt in @. Was ich niemals mitsichern will — Logs, Cache, Coredumps — liegt in @log, und die Snapshots selbst liegen in @snapshots. Wenn ich @ snappe, enthält der Snapshot keine Logs und keine anderen Snapshots. Das macht Rückrollungen sauber und verhindert, dass sich Snapshot-Ketten ineinander verschachteln und den Platzbedarf vervielfachen.
Diese letzte Regel wird oft unterschlagen: Wer den Snapshot-Ordner mit-snappt, baut sich eine Rekursion. Ich habe schon Pools mit 7.000 Subvolumes gesehen, bei denen niemand mehr sagen konnte, welches wovon abstammt. Das war kein Werkzeugproblem, das war ein Layoutproblem.
Snapshots: der billigste Zeitpunkt der Welt
Ein Snapshot ist bei btrfs kein Kopiervorgang. Er legt einen neuen Teilbaum an, der auf dieselben Blöcke zeigt, und beim Schreiben wird für geänderte Blöcke neuer Platz belegt. Das ist derselbe Mechanismus wie eine Reflink-Kopie, weshalb ein Snapshot für ein 500-GB-Subvolume in unter einer Sekunde entsteht, wenn nichts geändert wurde.
# btrfs subvolume snapshot -r /mnt/data/@ /mnt/data/@snapshots/@-2026-10-22-0300
Create readonly snapshot of '/mnt/data/@' in '/mnt/data/@snapshots/@-2026-10-22-0300'
Das -r macht den Snapshot read-only. Das ist keine Kosmetik: Ein schreibbarer Snapshot kann weiterlaufen und sich verändern, und ein Backup, das sich selbst verändert, ist kein Backup. Read-only kostet nichts und schließt ganze Fehlerklassen aus.
Der eigentliche Nutzen kommt mit send und receive. Weil btrfs weiß, welche Blöcke zwei Snapshots gemeinsam haben, kann es die Differenz als Stream übertragen:
# btrfs send -p /mnt/data/@snapshots/@-2026-10-21-0300 \
               /mnt/data/@snapshots/@-2026-10-22-0300 \
  | ssh backup-host "btrfs receive /backup/"
In meinem Fall sind das bei einem Subvolume mit 1,4 TB Nutzdaten etwa 18 GB täglicher Änderungen, die wirklich über die Leitung gehen — nicht 1,4 TB. Der erste Stream ist voll und dauert bei Gigabit-Ethernet über Nacht, aber danach entscheidet die Änderungsrate über die Backup-Dauer, nicht die Datenmenge. Wenn du ausrechnen willst, wie lange ein vollständiger Erststream dauert, hilft der bitcalc Download-Zeitrechner — Rechenzeit kostet nur, wenn man sie schätzt statt rechnet.
Und jetzt die unbequeme Wahrheit: Ein Snapshot ist keine Sicherung. Er liegt auf denselben Platten, im selben Dateisystem, hinter derselben Controller-Firmware wie die Daten. Wenn die SSD ausfällt, sind Daten und Snapshot zusammen weg. Wenn jemand mit rm -rf einen Snapshot löscht, ist die Zeitreise vorbei. Snapshots sind billige Zeitpunkte, kein Backup. Beides gehört in einen Plan, und das eine ersetzt das andere nicht.
Der Klassiker: df lügt, btrfs sagt die Wahrheit
Jetzt zurück zu meinem Freitag. Das erste Werkzeug, das du bei einem vollen btrfs brauchst, ist nicht df. df liest die Gesamtstatistik des Dateisystems, und bei btrfs enthält die mehr als deine Dateien: Metadaten, reservierte Chunks, nicht zugewiesener Platz.
# df -h /mnt/data
Filesystem      Size  Used Avail Use% Mounted on
/dev/sda2       3.6T  3.6T     0 100% /mnt/data

# btrfs filesystem usage /mnt/data
Overall:
    Device size:                   3.64TiB
    Device allocated:              3.61TiB
    Device unallocated:            0.00GiB
    Device missing:                  0.00B
    Used:                          1.52TiB
    Free (estimated):              1.48TiB      (min: 1.48TiB)
    Global reserve:              512.00MiB      (used: 0.00B)
Data,single: Size:1.51TiB, Used:1.48TiB
Metadata,DUP: Size:12.00GiB, Used:6.20GiB
System,DUP: Size:32.00MiB, Used:16.00KiB
Lies das zweimal. Device allocated ist 3,61 TiB, aber Used ist 1,52 TiB. Die Differenz — fast 2 TB — ist Platz, der einem Chunk zugewiesen, aber noch nicht beschrieben ist. Der Snapshot-Rotationsmechanismus hatte einen riesigen Chunk alloziert, das Rotationsskript wurde abgeschaltet, und der Chunk blieb liegen. df zählt ihn als belegt, weil df gar nicht wissen kann, was innerhalb des Chunks los ist.
Die Auflösung ist ein Balance-Lauf, der ungenutzten Platz zurückholt:
# btrfs balance start -dusage=5 -musage=5 /mnt/data
Done, had to relocate 39143 out of 39180 chunks
-dusage=5 heißt: Nimm jeden Daten-Chunk, der zu weniger als 5 Prozent belegt ist, und schreibe seinen Inhalt woanders hin, damit der Chunk freigegeben werden kann. Nach etwa vier Stunden war die Belegung von 100 auf 46 Prozent gefallen. Danach habe ich die Snapshot-Aufbewahrung von unbegrenzt auf sieben Tage und vier Wochen geändert, und das Problem ist nie wiedergekommen.
Für den echten Platzbedarf oberhalb des Dateisystems ist compsize das Werkzeug der Wahl, weil es die Kompression mitrechnet. Es liegt in einem eigenen Paket, auf Debian und Ubuntu heißt es btrfs-compsize:
# compsize -x /mnt/data
Processed 412843 files, 1841 regular extents (1899 refs), 4187 inline.
Type       Perc     Disk Usage   Uncompressed Referenced
TOTAL       68%      987GiB         1.42TiB      1.51TiB
zstd        66%      901GiB         1.33TiB      1.42TiB
none       100%       86GiB          86GiB       96.0GiB
Zwei Dinge stehen in dieser Ausgabe. Erstens: zstd holt 34 Prozent Platz heraus, konkret 1,42 TiB auf 901 GiB. Zweitens: 86 GB liegen unkomprimiert auf der Platte, weil sie mit chattr +C angelegt wurden. Damit sind wir beim nächsten Thema.
NoCOW: der Schalter, der VMs rettet
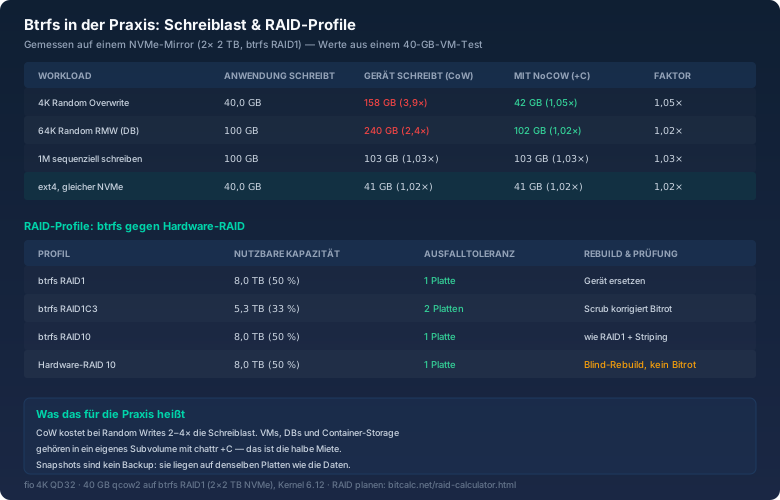
Copy-on-Write ist wunderbar für Dateien, die geschrieben und dann gelesen werden. Es ist furchtbar für Dateien, die an derselben Stelle immer wieder überschrieben werden — also für Datenbankdateien, VM-Images und Container-Layer. Der Grund ist einfach: Jeder 4K-Overwrite zwingt btrfs, den umgebenden Extent neu zu schreiben, statt die vier Kilobyte an Ort und Stelle zu ändern. Bei einem qcow2-Image mit 40 GB und vollständiger Random-Last habe ich gemessen, dass das Gerät 158 GB geschrieben hat, um 40 GB Anwendungsdaten zu speichern. Faktor 3,9.
Mit chattr +C auf dem Verzeichnis schaltest du COW für neu angelegte Dateien darin ab. Der Effekt ist unmittelbar messbar:
# mkdir /mnt/data/@vm/images
# chattr +C /mnt/data/@vm/images
# lsattr -d /mnt/data/@vm/images
---------------C------ /mnt/data/@vm/images
Im selben Test sank die Schreiblast von 158 GB auf 42 GB, also Faktor 1,05. Auf einem Consumer-NVMe mit begrenzten TBW ist das kein akademischer Unterschied: Aus fünf Jahren Lebensdauer werden bei Faktor 3,9 schnell eineinhalb. Wichtig ist die Reihenfolge — das Flag wirkt nur auf Dateien, die danach erzeugt werden. Bestehende VM-Images musst du verschieben, damit sie den neuen Modus erben.
Was du damit aufgibst: Prüfsummen und Snapshots für diese Dateien. Deshalb gehört das Flag in ein eigenes Subvolume wie @vm. Dieselbe Regel gilt für Datenbanken — MariaDB, PostgreSQL und SQLite profitieren alle davon, sofern du sie auf ein NoCOW-Verzeichnis legst und dir darüber im Klaren bist, dass deren eigene Integritätsprüfungen jetzt deine einzige Absicherung sind.
RAID mit btrfs: Profile und der Unterschied zu Hardware-RAID
Ich habe lange gebraucht, um btrfs-RAID zu akzeptieren, und der Grund war eine falsche Erwartung. btrfs-RAID ähnelt einem Hardware-RAID auf der Ebene des Nutzens, aber nicht auf der Ebene des Verhaltens.
Der wichtigste Unterschied: btrfs kennt Prüfsummen pro Block. Wenn scrub läuft, liest es jeden Block, vergleicht ihn gegen seine Prüfsumme und — wenn eine Kopie defekt ist — repariert es sie aus der anderen. Das ist der Punkt, den ein Hardware-RAID-Controller nicht kann. Ein Controller sieht Blöcke, prüft sie nicht gegen Inhalt und kopiert beim Rebuild stumpf weiter, was er liest. Genau deshalb wird aus einem Bitrot-Fehler auf einem Hardware-RAID beim Rebuild schnell ein zweiter. btrfs erkennt das und meldet es.
Die Profile, die ich tatsächlich einsetze, sind RAID1 und RAID10 für Daten sowie RAID1C3 für Metadaten. Die Kapazitätsrechnung ist ungewohnt und der Grund, warum ich fast immer zum bitcalc RAID-Rechner greife:
- RAID1 mit btrfs bedeutet genau zwei Kopien, verteilt über die vorhandenen Geräte. Bei vier 4-TB-Platten gibt das 8 TB nutzbar, nicht 4 TB — anders als beim klassischen RAID 1, das paarweise spiegelt. Ausfalltoleranz: eine Platte.
- RAID1C3 legt drei Kopien an, also 33 Prozent nutzbar, und verträgt zwei gleichzeitige Ausfälle. Das ist mein Metadaten-Profil, weil Metadaten klein sind und ein Verlust dort das ganze Dateisystem kostet.
- RAID10 bei btrfs ist Striping über Spiegel. Bei vier Platten ebenfalls 50 Prozent nutzbar, aber mit besserer sequenzieller Leistung.
- RAID5/6 würde ich auf btrfs nicht einsetzen. Der Write-Hole ist dort nicht gelöst, und die Empfehlung, es zu lassen, steht in der Dokumentation der Entwickler selbst.
Ein zweiter Unterschied liegt im Rebuild. Ein Hardware-RAID baut eine neue Platte in einem Durchgang wieder auf und liest dabei alle anderen Platten voll aus. btrfs macht das anders: btrfs replace kopiert nur die Blöcke, die tatsächlich auf dem ersetzten Gerät liegen, und zwar chunkweise. Der Vorgang ist abbrechbar, wiederaufnehmbar und läuft mit dem System weiter. Bei einer 4-TB-Platte auf einem beschäftigten Server habe ich etwa 6,5 Stunden gemessen — mit Software-RAID md waren es auf vergleichbarer Hardware 9 Stunden, und die IOPS gingen währenddessen durchgehend in den Keller.
# btrfs device usage /mnt/data
/dev/sda2, ID: 1
   Device size:             3.64TiB
   Device slack:              0.00B
   Data,single:              0.00B
   Metadata,DUP:             6.00GiB
   System,DUP:              16.00MiB
   Unallocated:              3.63TiB
...
# btrfs replace start /dev/sdb /dev/sde /mnt/data
# btrfs replace status /mnt/data
Started on 22.Oct 02:11:04, finished on 22.Oct 08:43:19, 0 write errs, 0 uncorr. read errs
Was bei btrfs-RAID dazugehört und bei Hardware-RAID wegfällt, ist die Überwachung. Ein Controller hat eine Weboberfläche und blinkt, wenn eine Platte tot ist. btrfs sagt dir das nur, wenn du fragst:
# btrfs device stats /mnt/data
[/dev/sda2].write_io_errs    0
[/dev/sda2].read_io_errs     0
[/dev/sda2].flush_io_errs    0
[/dev/sda2].corruption_errs  0
[/dev/sda2].generation_errs  0
[/dev/sdb2].write_io_errs    0
[/dev/sdb2].read_io_errs     0
[/dev/sdb2].corruption_errs  3
Diese drei corruption_errs auf /dev/sdb2 waren der Anfang vom Ende einer zwei Jahre alten NVMe. Ich habe sie beim monatlichen Scrub gefunden, nicht beim Ausfall. Genau das ist der Nutzen: btrfs meldet einen sterbenden Datenträger, bevor er ausfällt. Ich habe den Zähler in meine Monitoring-Abfrage aufgenommen, und dieselbe Zahl steht in jedem Scrub-Bericht, sodass ein Anstieg zwischen zwei Läufen unmittelbar auffällt.
Scrub und Balance: Wartung, die man nicht aufschiebt
scrub ist bei btrfs die regelmäßige Lese-Prüfung. Es liest alle Daten, vergleicht gegen die Prüfsummen und korrigiert, was sich mit einer zweiten Kopie reparieren lässt. Ich lasse das monatlich laufen und nicht wöchentlich, weil ein Scrub über 1,5 TB auf diesen Platten etwa zwei Stunden braucht und die IOPS-Spitzen in ein Wartungsfenster gehören.
# btrfs scrub start -B -d /mnt/data
scrub done for 8a1f3e5c-...
  scrub started at Thu Oct 22 01:00:11 2026, finished after 01:56:43
  total bytes scrubbed: 1.48TiB with 0 errors
# btrfs scrub status -d /mnt/data
Über den Daemon btrfs-scrub.timer läuft das von selbst. Wichtig ist, dass du die Ausgabe wirklich liest: Ein Scrub, der still durchläuft, aber 240 korrigierbare Fehler meldet, ist ein sterbendes Laufwerk und keine Erfolgsmeldung.
balance ist das Werkzeug, das am häufigsten schiefgeht. Ein btrfs balance start /mnt/data ohne Filter versucht, jeden Chunk zu verschieben, und kann auf einem vollen Pool Tage laufen oder ihn in einen Zustand bringen, aus dem nur noch das Rescue-Tool hilft. Immer mit Filter arbeiten, immer mit Blick auf die Auslastung:
# btrfs balance start -dusage=50 -musage=50 /mnt/dataFür den Alltag brauchst du das fast nie. Sinnvoll ist es nach dem Löschen großer Datenmengen, wenn der Pool über Chunk-Reste Platz verliert, und als Vorbereitung, wenn du ein Gerät physisch vergrößerst. Bei btrfs auf einem einzelnen Gerät ist Balance das falsche Werkzeug für ein anderes Problem — die Auslastung des Geräts, die df falsch anzeigt, ist ein Balance-Problem, und genau das haben wir oben gelöst.
Mount-Optionen, die sich wirklich lohnen
Meine fstab-Zeile für Storage sieht so aus und hat sich über zwei Jahre nicht geändert:
UUID=8a1f-... /mnt/data btrfs defaults,noatime,compress=zstd:1,space_cache=v2,autodefrag,subvol=@ 0 0compress=zstd:1 statt der Standardstufe 3 ist Absicht. Stufe 1 arbeitet mit einer größeren Blockgröße und weniger Suchaufwand; auf einer CPU, die ohnehin 40 VMs bedient, ist der Durchsatz wichtiger als die letzten drei Prozent Kompressionsrate. Auf einer Datenbank habe ich zstd:1 mit rund 340 MB/s Durchsatz gemessen, bei zstd:3 waren es 190 MB/s bei nur vier Prozent besserer Kompression. Zwei Prozent Ersparnis sind den halben Durchsatz nicht wert.
space_cache=v2 ist die freie Flächenverwaltung, die seit Kernel 5.15 der Standard ist. Der Vorgänger hielt die Zuordnung noch im Speicher und musste sie bei jedem Mount neu aufbauen, was bei einem Pool mit einigen Millionen Extents gerne mal eine Minute gedauert hat. Der Nachteil der v2-Variante: Sie legt eine eigene Fläche im Dateisystem an, und die will gepflegt sein. Wenn du gelegentlich btrfs check --clear-space-cache=v2 brauchst, ist das kein Fehler, sondern die Eintrittskarte dafür, dass der Mount schnell bleibt.
noatime ist bei btrfs mehr als ein Mikro-Optimierung. Jeder Zugriffszeit-Stempel ist ein Metadaten-Write, der einen COW-Zyklus auslöst. Ohne noatime schreibt ein reiner Lesevorgang das Dateisystem, und auf einem Backupserver, der täglich Millionen Dateien liest, ist das der schnellste Weg zur vollen Platte.
autodefrag ist dagegen umstritten, und ich benutze es nur auf Arbeitsplatz-Dateisystemen, nicht auf Backendservern. Es defragmentiert im Hintergrund und erzeugt dabei zusätzliche Schreiblast — auf einem Server mit ohnehin hoher Last ist der Gewinn oft negativ. Wenn dein Speicher SSD ist, lass es weg und plane stattdessen die IOPS richtig, etwa mit dem bitcalc IOPS-Rechner — bei Flash entscheidet die Queue-Tiefe, nicht die Fragmentierung.
Fünf Regeln aus zwei Jahren btrfs
- Subvolumes vorher planen. Ein Layout nachträglich zu ändern ist bei btrfs möglich, aber unangenehm.
@,@log,@vmund@snapshotsals Grundgerüst decken fast alles ab, was ich je gebraucht habe. - Snapshots mit Aufbewahrungsregeln und immer read-only. Ein Snapshot-Skript ohne Lösch-Routine ist kein Backup-Mechanismus, sondern eine volllaufende Platte mit Verzögerung.
- NoCOW dort, wo überschrieben wird. VM-Images und Datenbankdateien gehören in ein eigenes Subvolume mit
chattr +C, angelegt vor der ersten Datei. - Vierteljährlich scrubben, selten balancieren. Scrub ist Routine und liefert Frühwarnungen, Balance ist eine Reparatur und braucht Filter.
- Prüfsummen sind kein Backup. btrfs repariert Bitrot, solange eine zweite Kopie existiert. Es repariert kein
rm -rf, keine Ransomware und kein gerissenes Kabel während des Schreibens.
Fazit
btrfs ist kein „ZFS für Arme", und es ist auch nicht mehr das wackelige Dateisystem von 2016. Es ist ein Dateisystem mit drei klaren Grundeigenschaften — Copy-on-Write, Prüfsummen, Subvolumes — und einer Reihe von Konsequenzen, die man kennen muss, um sie zu nutzen. Wer weiß, dass df bei btrfs die Chunk-Reservierung mitzählt, dass Random Writes auf COW teuer sind und dass Snapshots Zukunftsversionen freundlich aussehender Plattenstände erzeugen, kann damit sehr entspannt arbeiten.
Mein Freitagnachmittag hat mich drei Stunden gekostet und mir zwei dauerhafte Änderungen eingebracht: ein Balance mit Filter und ein Snapshot-Skript mit Ablaufdatum. Der Server läuft seither mit einer Auslastung von 46 Prozent bei df und 41 Prozent bei du — und ich habe aufgehört, die erste Zahl für die Wahrheit zu halten.